Jak zbudować drzewo decyzyjne konsumenta: dlaczego najlepsze drzewa CDT zaczynają się od zachowań kupujących, a nie od logiki podaży
Nov 9, 2026 • 12 min
Zbudowanie drzewa decyzyjnego konsumenta wydaje się proste – dopóki ktoś nie zapyta: „Kto je zbudował?” i „Jak je zbudowano?”
Większość menedżerów kategorii nie budowała własnego drzewa CDT. Drzewo trafiło do nich od dostawcy marki, firmy doradczej lub wewnętrznego zespołu kategorii, który dawno zajął się już czymś innym. A mimo to od tamtej pory optymalizują asortyment w jego ramach. Co roku aktualizują produkty, spierają się o nazwy węzłów i prowadzą przeglądy asortymentu na podstawie struktury, którą ktoś inny zbudował jednorazowo, z powodów, które mogły już stracić znaczenie.
To ma większe znaczenie, niż mogłoby się wydawać. Drzewo decyzyjne konsumenta leży u podstaw każdej decyzji asortymentowej sieci handlowej. Wyznacza, które produkty trafiają do oferty, a które nie, w odniesieniu do poszczególnych potrzeb konsumentów – dzięki temu asortyment ma odpowiednią szerokość i głębokość.
Jeśli struktura jest błędna, sieć handlowa może osiągać dobre wyniki we wszystkich wskaźnikach finansowych i jednocześnie po cichu pozostawiać w całości niezaspokojoną jedną z potrzeb konsumentów. W danych nie pojawi się żaden sygnał ostrzegawczy, bo drzewo nie odzwierciedla tego, jak kupujący naprawdę podejmują decyzje.
Samo aktualizowanie obecnego drzewa nie wystarczy. Trzeba zbudować kolejne na podstawie rzeczywistych zachowań kupujących – widocznych w tym, jak produkty współwystępują w koszykach i w kolejnych wizytach.
Jak obecnie powstają drzewa decyzyjne konsumenta (CDT)
Menedżerowie kategorii mają kilka typowych sposobów, by dojść do drzewa decyzyjnego konsumenta. Każdy z nich wygląda inaczej, ale wszystkie mają to samo podstawowe ograniczenie: takie drzewa utrwalają jeden moment, a kategoria w tym czasie idzie naprzód.
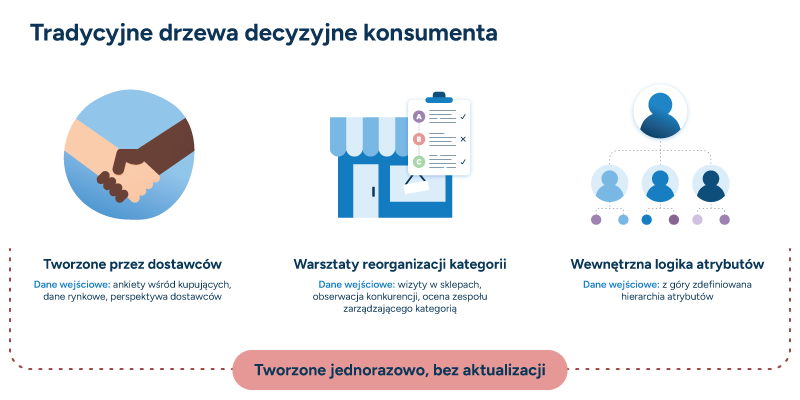
Drzewa tworzone przez dostawców
To najczęstsze źródło drzew CDT. Dostawcy marek i firmy doradcze z zakresu zarządzania kategoriami dobrze znają kategorie i mają możliwości badawcze, których większość sieci handlowych nie ma u siebie – dlatego naturalnie sprawdzają się w takich zadaniach. Badania zwykle łączą ankiety wśród kupujących, dane rynkowe i doświadczenie w danej kategorii. Powstaje z nich hierarchia atrybutów ułożona w kolejności, w jakiej – zdaniem dostawcy – kupujący podejmują decyzje.
Takie drzewo pokazuje, które produkty tworzą grupę i jak należy poruszać się po kategorii – od węzła kategorii najwyższego poziomu aż po poszczególne SKU na poziomie liści (czyli najniższych węzłów).
Warsztaty resetu kategorii
Alternatywą dla sieci handlowych, które budują własne drzewa CDT, są warsztaty resetu kategorii. Wizyty w sklepach, obserwacja konkurencji i ocena menedżerów kategorii składają się na uporządkowane ćwiczenie, które opiera się na bezpośredniej znajomości kategorii w jednym wybranym okresie. Efektem jest hierarchia zbudowana na obserwacji tego, jak kategorie są zorganizowane na rynku. Zespół kategorii interpretuje ją przez pryzmat własnego doświadczenia, a strukturę weryfikuje, zestawiając ją z danymi o wynikach sprzedaży.
Wewnętrzna logika atrybutów
Trzeciemu podejściu najczęściej nikt się nie przygląda. Drzewa powstają tu z hierarchii atrybutów produktów, które zespół kategorii określa samodzielnie na podstawie tego, jak kategoria jest zorganizowana. Atrybuty są ustawiane w kolejności odzwierciedlającej to, jak zespół rozumie kategorię, a produkty trafiają do węzłów zgodnie z miejscem, w którym plasują je ich atrybuty.
Wśród atrybutów, według których układa się hierarchię, mogą być:
- marka,
- wielkość,
- format,
- smak,
- przedział cenowy.
Każdy węzeł najniższego poziomu obejmuje wtedy produkty o takiej samej ścieżce atrybutów – od góry do dołu drzewa.
Dlaczego odziedziczone drzewa CDT pozostawiają potrzeby konsumentów niezaspokojone?
Każda z typowych metod budowania drzewa CDT ma własną wadę, ale skutek jest zawsze ten sam, niezależnie od sposobu powstania drzewa. To drzewo CDT decyduje o tym, co podlega ochronie. Jeśli jakaś potrzeba konsumentów nie została w nim uwzględniona, system nie ma jak zasygnalizować jej braku. Po prostu uzupełnia asortyment z istniejących węzłów, a luka pozostaje niewidoczna.
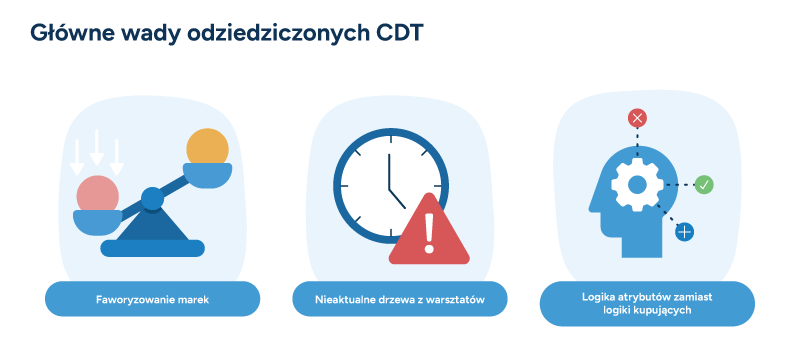
Dostawca wynosi markę na szczyt
Jeśli marka znajduje się blisko szczytu hierarchii, bo tak ustawił ją dostawca, drzewo odzwierciedla priorytety dostawcy, a nie decyzje kupujących. Ktoś, dla kogo pierwszym kryterium jest okazja, format albo kraj pochodzenia, porusza się po kategorii w innej kolejności, niż zakłada drzewo. W logice drzewa asortyment może wyglądać na kompletny, a jednocześnie systematycznie nie zaspokajać potrzeb kupujących, którzy nie zaczynają od marki. Nic nie pozwala wychwycić tego problemu, bo to samo drzewo definiuje, co znaczy „kompletny”.
Drzewa z warsztatów szybko się dezaktualizują
Warsztaty resetu kategorii dają obraz z jednego momentu. W krótkim okresie to przydatne, ale zachowania kupujących się zmieniają, pojawiają się nowe formaty, zmienia się sytuacja konkurencyjna, rosną marki własne, a drzewo nie nadąża za tymi zmianami. Menedżer kategorii może czuć, że coś jest nie tak, ale drzewo CDT tego nie potwierdza, bo powstało jako odbicie chwili, która jest już nieaktualna. Aktualizacja oznacza ponowne przeprowadzenie warsztatów, czyli czekanie na kolejny cykl, zanim będzie można wprowadzić potrzebne zmiany.
Logika atrybutów myli uporządkowanie z wnioskami
Drzewo zbudowane z atrybutów produktów (takich jak marka, wielkość, smak czy format) pokazuje, jak kategoria jest uporządkowana w bazie danych, a niekoniecznie to, jak kupujący przechodzi przez proces decyzyjny. Na papierze jedno i drugie może wyglądać podobnie, a w praktyce znacznie się różnić. Załóżmy, że kupujący prędzej sięgnie po inną markę, niż zmieni jeden format na drugi, a w drzewie marka stoi nad formatem. Wtedy hierarchia jest odwrócona względem rzeczywistego zachowania. Kolejne decyzje asortymentowe będą optymalizowane według błędnej logiki.
Lepszy sposób budowania drzewa decyzyjnego konsumenta: zacznij od danych o substytucji
Metoda, która rozwiązuje wszystkie problemy odziedziczonych drzew CDT, zaczyna się od innego pytania. Zamiast pytać: „Jak powinniśmy pogrupować te produkty?”, zapytaj: „Które produkty kupujący naprawdę traktują jako wzajemnie zastępcze?”
Punktem wyjścia są dane transakcyjne POS, czyli rzeczywiste zapisy tego, co kupujący kupowali w kolejnych koszykach i w kolejnych wizytach. Zamiast narzucać hierarchię opartą na atrybutach produktów lub wskazówkach dostawcy, menedżerowie kategorii pozwalają, by strukturę wyznaczyły wzorce współwystępowania produktów w danych.
Powstające drzewo pokazuje, jak zachowują się kupujący, gdy nie ma ich pierwszego wyboru albo gdy porównują opcje w obrębie kategorii. To drzewo CDT nie opiera się na tym, jak według dostawcy powinni się zachowywać, ani na tym, jak kategoria wyglądała na warsztatach resetu dwa lata temu.
Zamiast narzucać hierarchię opartą na atrybutach produktów lub wskazówkach dostawcy, menedżerowie kategorii pozwalają, by strukturę wyznaczyły wzorce współwystępowania produktów w danych.
W praktyce powstała hierarchia często zaskakuje. Drzewo kategorii higieny osobistej przygotowane przez dostawcę może umieszczać markę wysoko w hierarchii, choć dane transakcyjne mogą opowiadać inną historię. Gdy pierwszego wyboru nie ma na półce, dla kupujących sposób aplikacji może mieć większe znaczenie niż marka.
Na przykład kupujący może prędzej sięgnąć po dezodorant innej marki, niż zmienić formę z kulki (roll-on) na spray. Jeśli taki wzorzec konsekwentnie powtarza się w tysiącach transakcji, powinien znaleźć odzwierciedlenie w drzewie – zamiast wynikać z atrybutów produktów czy wskazówek dostawcy.
Zasada jest prosta. Drzewo CDT powinno odzwierciedlać wyłącznie zachowania konsumentów, a znajomość kategorii służy do wyjaśniania i nazywania tego, co pokazują dane. Dane wyznaczają strukturę, a menedżer kategorii ją interpretuje, nazywa węzły i dopracowuje drzewo tak, by dało się z niego korzystać.
Dlaczego drzewa CDT oparte na substytucji dają lepsze wyniki asortymentowe
Pierwszą zaletą drzew CDT opartych na substytucji jest pełniejsze pokrycie potrzeb. Bez wiarygodnego drzewa bestsellery kategorii zwykle skupiają się w jednym lub dwóch węzłach. Optymalizator asortymentu, który działa poprawnie na przekazanej mu strukturze, dobrze uzupełnia te węzły. Oznacza to głębię tam, gdzie asortyment już wygrywał, i pustkę tam, gdzie brakowało pokrycia. Drzewo oparte na substytucji rozkłada węzły dokładniej, zgodnie z rzeczywistym kształtem popytu kupujących, więc optymalizator chroni to, co trzeba.
Druga zaleta: dane o współwystępowaniu w skali transakcji trudno podważyć, w przeciwieństwie do drzewa CDT od dostawcy. Hierarchię stworzoną przez dostawcę można zakwestionować, odwołując się do intuicji, ale spójne wzorce współwystępowania w setkach tysięcy koszyków trudniej zbyć. Gdy dane pokazują coś nieoczekiwanego, zwykle wskazują to, co umknęło podczas ostatnich warsztatów kategorii – i właśnie o to chodzi.
Trzecia zaleta to skalowalność. Ręcznie zbudowane drzewo CDT to praca jednej osoby, wykonywana raz na kategorię w cyklu, a jej tempo ogranicza liczba kategorii, które ta osoba zdąży opracować w ciągu roku. Model wykrywający wzorce współwystępowania w danych transakcyjnych może działać na wielu kategoriach jednocześnie, a specjalista sprawdza i zatwierdza wyniki, zamiast budować wszystko od zera. Praca przesuwa się z konstruowania na krytyczną analizę, co daje doświadczeniu w danej kategorii lepsze zastosowanie.
Czego potrzeba, by zbudować drzewo decyzyjne konsumenta na podstawie danych o zachowaniach kupujących
Zbudowanie drzewa CDT opartego na zachowaniach to coś więcej niż wybór metody. Wymaga też konkretnych danych i technologii.
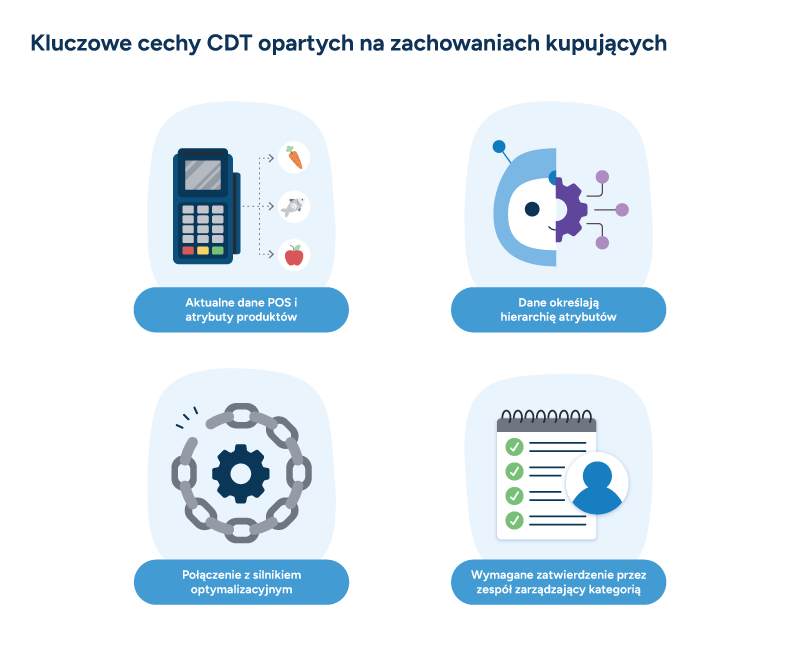
Aktualne dane POS na poziomie koszyka i atrybuty produktów
Podstawę stanowią dwa elementy, które muszą się uzupełniać:
- dane transakcyjne pokazujące, co kupujący kupowali w poszczególnych koszykach i w kolejnych wizytach,
- uporządkowany eksport atrybutów produktów, który opisuje właściwości każdego SKU (format, marka, smak, przedział cenowy itp.).
Sygnał substytucji pochodzi z indywidualnych wzorców zakupowych, a nie z sum dla kategorii, więc zagregowane dane sprzedażowe nie wystarczą. Model potrzebuje obu źródeł, żeby ustalić, które atrybuty wyjaśniają różnice między produktami traktowanymi przez kupujących jako zastępcze.
Wytrenowany model, który szereguje atrybuty według mocy wyjaśniającej
Najważniejsza różnica między drzewem opartym na zachowaniach a tradycyjnym polega na sposobie ustalania hierarchii.
W tradycyjnym drzewie CDT ktoś z góry przesądza, że marka stoi nad formatem albo format nad wielkością, kierując się własną oceną lub przyjętym zwyczajem.
W podejściu opartym na wzorcach współwystępowania wytrenowany model analizuje dane transakcyjne klienta i sam decyduje, według których atrybutów dzielić drzewo i w jakiej kolejności. Podstawą decyzji jest to, jak dobrze dany atrybut wyjaśnia różnice między produktami w każdej gałęzi.
Efektem jest hierarchia wynikająca z rzeczywistych zachowań kupujących. Produkty, które trafiają do tego samego węzła końcowego, są według tej logiki traktowane jako zastępcze – to właśnie po nie sięga kupujący, gdy nie ma jego pierwszego wyboru.
Bezpośrednie połączenie z silnikiem optymalizacji
Drzewo CDT odizolowane od procesu planowania asortymentu rozwiązuje tylko część problemu. Kolejne decyzje, takie jak „które produkty są podstawowe?”, „które są opcjonalne?” i „co podlega racjonalizacji?”, muszą opierać się na tej samej logice kupujących, na której zbudowano drzewo.
Gdy drzewo CDT zasila bezpośrednio silnik optymalizacji asortymentu w systemie planistycznym, jego struktura przekłada się na każdą decyzję asortymentową. Optymalizator może wtedy traktować każdy węzeł końcowy jako ograniczenie pokrycia. Dzięki temu asortyment zawiera co najmniej jeden produkt dla każdej potrzeby konsumentów, a nie jest uzupełniany na podstawie zagregowanych sum kategorii.
Model aktywacji, który pozostawia kontrolę w rękach specjalisty
Model, który generuje drzewa decyzyjne automatycznie i wdraża je bez przeglądu, tworzy inny problem. Menedżerowie kategorii tracą widoczność tego, co się zmieniło i dlaczego, a zaufanie szybko spada.
Właściwe podejście polega na tym, że nowe drzewa są domyślnie nieaktywne. Nic nie zostaje uruchomione, dopóki menedżer kategorii nie sprawdzi wyników, nie nazwie węzłów, nie zweryfikuje grup produktów zastępczych pod kątem realiów handlowych i nie zatwierdzi aktualizacji. Ten element metody najłatwiej zlekceważyć, a to właśnie dzięki niemu działa cała reszta.
Menedżerowie kategorii pracujący w ten sposób dokładnie wiedzą, jak ma to wyglądać. Chodzi o to, żeby usiąść do pracy w odpowiednim nastawieniu i czuć, że to oni tworzą swoje drzewo CDT, a nie odkrywać, że ktoś zrobił to za nich. Model działa według harmonogramu, a o tym, kiedy nowa wersja zostanie uruchomiona, decyduje menedżer kategorii.
Rola oceny przesuwa się z budowania drzewa od zera na krytyczną analizę tego, co wykazały dane, oraz na decydowanie, którym jego elementom zaufać. To lepsze zastosowanie doświadczenia w danej kategorii niż ręczna klasyfikacja atrybutów.
Jak narzędzie RELEX CDT Builder wdraża tę metodę w praktyce
Narzędzie RELEX CDT Builder łączy dane wejściowe, podejście modelowe i model aktywacji, których wymaga budowanie drzew CDT na podstawie zachowań. Jest elementem rozwiązania RELEX do planowania asortymentu, które działa na zintegrowanej platformie RELEX. Dzięki temu decyzje asortymentowe są powiązane z planowaniem przestrzeni sprzedażowej, popytu i uzupełniania zapasów.
Proces opiera się na wytrenowanym modelu tematycznym, który wykrywa wzorce zachowań w danych koszykowych. Typowe uruchomienie budowy trwa kilka minut na kategorię i można je skonfigurować na poziomie kategorii. Menedżerowie kategorii mogą kontrolować maksymalną głębokość drzewa, minimalną wielkość węzła oraz to, które atrybuty muszą lub nie mogą pojawiać się na każdej ścieżce.
Powstałe drzewo łączy się bezpośrednio z narzędziem Assortment Optimizer, w którym każdy węzeł końcowy pełni funkcję ograniczenia pokrycia. Optymalizator dba o to, by asortyment zawierał co najmniej jeden produkt dla każdej potrzeby konsumentów. Dzięki temu głębokość w węzłach, które już się sprawdzają, i pokrycie tych niedostatecznie obsłużonych są zarządzane łącznie, a nie przeciwstawiane sobie. Menedżerowie kategorii sprawdzają i nazywają wyniki, weryfikują grupy produktów zastępczych na podstawie własnej znajomości kategorii i aktywują drzewo, gdy są z niego zadowoleni. Zachowują w ten sposób pełną kontrolę nad tym, co zostaje uruchomione i kiedy.
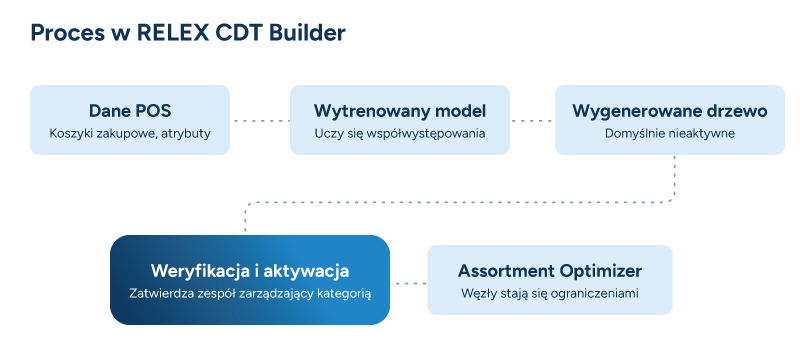
Dla zespołów zarządzających dużymi lub złożonymi portfelami kategorii zmiana w skali działania jest znacząca. Narzędzie CDT Builder działa na wielu kategoriach jednocześnie, a menedżerowie kategorii sprawdzają i zatwierdzają wyniki, zamiast budować wszystko od zera. Praca przesuwa się z konstruowania na krytyczną analizę, a kategorie, które wcześniej czekałyby miesiącami na ręczną przebudowę drzewa, są aktualizowane według harmonogramu wyznaczanego przez model.
Dalszy rozwój opiera się na tym fundamencie. Prognozowanie uwzględniające transfer popytu, w tym prognozowanie dla nowych produktów na podstawie przypisania do węzła drzewa CDT, rozszerzy tę samą logikę opartą na zachowaniach z decyzji asortymentowych na szersze procesy planowania.
Niech kolejna przebudowa drzewa CDT naprawdę coś zmieni
Większość menedżerów kategorii pracuje na drzewie CDT, które zbudował ktoś inny, metodą sensowną w swoim czasie. Dziś to drzewo pilnie wymaga aktualizacji. Pytanie brzmi, czy następna wersja powstanie na podstawie tego, jak kupujący naprawdę się zachowują, czy na tych samych założeniach co poprzednia.
Jeśli chcesz zacząć taką zmianę, naturalnym kolejnym krokiem jest rozwiązanie RELEX do planowania asortymentu. Powstało na bazie metody opartej na substytucji i ma przywrócić menedżerom kategorii kontrolę nad strukturą, od której zależą ich asortymenty.
Autor
Powiązane artykuły
Agentyczna AI w planowaniu łańcucha dostaw producentów
Sprawdź, jak agentyczna AI pomaga producentom przeglądać prognozy, usuwać ograniczenia i testować plany. Agenci ogólni i dopasowani do potrzeb w RELEX Open.
7 sposobów, w jakie oprogramowanie AI do planowania rozwiązuje wyzwania w łańcuchu dostaw producentów mięsa
Poznaj siedem możliwości planowania łańcucha dostaw z wykorzystaniem AI, które pomagają ograniczyć spadek marż w produkcji mięsa czerwonego.
Historia klienta: Biyoute Trading
Bez braków towaru i bez nadmiaru zapasów podczas chińskiego Nowego Roku: prezes Biyoute o budowaniu prawdziwego partnerstwa z RELEX.