Como construir uma árvore de decisão do consumidor: por que as melhores CDTs partem do comportamento do shopper, e não da lógica do fornecedor
Nov 9, 2026 • 12 min
Construir uma árvore de decisão do consumidor parece simples até que alguém pare e pergunte: “Quem a construiu?” e “Como foi construída?”
A maioria dos gerentes de categoria não construiu a própria CDT. Eles a herdaram de um fornecedor de marca, de uma consultoria ou de um time interno de categoria que há muito tempo seguiu outro rumo. Mesmo assim, desde então otimizam dentro dessa estrutura. Atualizam os produtos todos os anos, discutem nomes de nós e conduzem revisões de sortimento sobre uma estrutura montada uma única vez por outra pessoa, por motivos que talvez já não se apliquem.
Isso importa mais do que parece. Uma árvore de decisão do consumidor está na base de todas as decisões de sortimento de um varejista. Ela define quais produtos são selecionados, ou não, em cada necessidade do consumidor, para garantir a amplitude e a profundidade certas e chegar a um sortimento ideal.
Se a estrutura estiver errada, o varejista pode ter bom desempenho em todos os indicadores financeiros e, sem que ninguém perceba, deixar uma necessidade inteira do consumidor sem atendimento. Nenhum sinal de alerta aparece nos dados, porque a árvore não reflete como os shoppers realmente tomam decisões.
Atualizar a árvore de decisão existente não basta. A solução é construir a próxima a partir do comportamento real dos shoppers — captado na forma como os produtos coocorrem nas cestas e nas visitas ao longo do tempo.
Como as árvores de decisão do consumidor (CDTs) são construídas hoje
Os gerentes de categoria costumam chegar a uma árvore de decisão do consumidor por alguns caminhos comuns. Cada um funciona à sua maneira, mas todos têm a mesma limitação fundamental: essas árvores capturam um único retrato, que permanece fixo enquanto a categoria segue em frente.
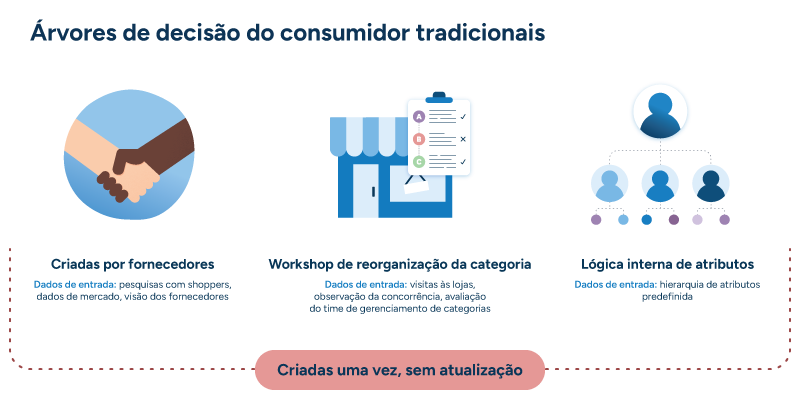
Árvores criadas por fornecedores
Esta é a origem mais comum das CDTs. Fornecedores de marcas e consultorias de gerenciamento de categorias trazem conhecimento genuíno de categoria e capacidade de pesquisa que a maioria dos varejistas não tem internamente, o que os torna uma escolha natural para esse tipo de trabalho. A pesquisa costuma combinar levantamentos com shoppers, dados de mercado e expertise em categoria para produzir uma hierarquia de atributos, ordenada na sequência em que o fornecedor acredita que os shoppers decidem.
A árvore resultante mostra quais produtos pertencem ao mesmo grupo e como a categoria deve ser navegada, do nó de categoria no topo até os SKUs individuais no nível das folhas (os nós mais baixos da árvore).
Workshops de reset de categoria
A alternativa para os varejistas que constroem as próprias CDTs é o workshop de reset de categoria. Visitas a lojas, observação de concorrentes e o julgamento dos gerentes de categoria se combinam em um exercício estruturado, que aproveita o conhecimento de primeira mão da categoria ao longo de um único período. O resultado é uma hierarquia construída a partir da observação direta de como as categorias são organizadas no mercado. Uma hierarquia interpretada pela ótica da expertise do time de categoria e cruzada com dados de desempenho de vendas para validar a estrutura.
Lógica interna de atributos
A terceira abordagem é a que muitas vezes passa sem ser questionada. As árvores de decisão são montadas a partir de hierarquias de atributos de produto, definidas internamente pelo time de categoria com base em como a categoria está organizada. Os atributos são ordenados em uma sequência que reflete como o time entende a categoria, e os produtos são alocados aos nós conforme a posição que seus atributos lhes dão nessa hierarquia.
Os atributos ordenados podem incluir:
- Marca
- Tamanho
- Formato
- Sabor
- Faixa de preço
Cada nó de nível mais baixo reúne, então, os produtos que compartilham o mesmo caminho de atributos, do topo à base da árvore.
Por que as CDTs herdadas deixam necessidades do consumidor sem atendimento?
Cada método típico de construção de CDT tem sua falha específica, mas todos levam à mesma consequência, não importa como a árvore foi construída. A CDT determina o que é protegido. Se uma necessidade do consumidor não está representada na árvore, o sistema não tem como sinalizar sua ausência. Ele simplesmente preenche o sortimento a partir dos nós que existem, e a lacuna continua invisível.
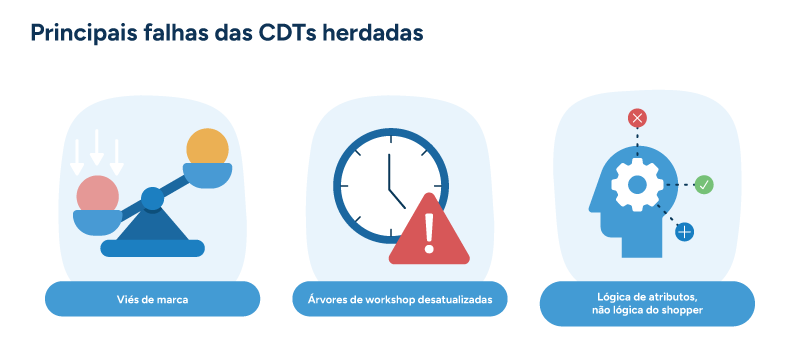
O viés do fornecedor coloca a marca no topo
Quando a marca fica no alto da hierarquia porque um fornecedor a colocou ali, a árvore reflete as prioridades do fornecedor, e não as decisões dos shoppers. Um shopper cujo primeiro critério é a ocasião, o formato ou o país de origem vai navegar pela categoria em uma sequência que a árvore não modela. O sortimento pode parecer abrangente pela lógica da árvore e, ao mesmo tempo, atender mal, de forma sistemática, os shoppers que não começam pela marca. Não há nenhum mecanismo capaz de trazer esse problema à tona, porque a própria árvore define o que significa “abrangente”.
Árvores de workshop ficam defasadas
Um workshop de reset de categoria produz um retrato do momento. Isso é útil no curto prazo, mas o comportamento dos shoppers muda, novos formatos surgem, a dinâmica competitiva se altera, a marca própria cresce, e a árvore não acompanha nada disso. O gerente de categoria pode sentir que algo está fora do lugar, mas a CDT não confirma, porque foi construída para refletir um momento que já ficou para trás. Atualizá-la significa fazer o workshop de novo, o que, por sua vez, significa esperar até o próximo ciclo para fazer os ajustes necessários.
A lógica de atributos confunde organização com insight
Uma árvore construída a partir de atributos de produto (como marca, tamanho, sabor ou formato) reflete como a categoria está organizada em um banco de dados, e não necessariamente como o shopper percorre uma decisão. As duas coisas podem parecer semelhantes no papel, mas divergem bastante na prática. Se um shopper troca de marca antes de trocar de um formato para outro, mas a árvore coloca a marca acima do formato, a hierarquia fica invertida em relação ao comportamento real. As decisões de sortimento que vêm depois serão otimizadas com base na lógica errada.
A melhor forma de construir uma árvore de decisão do consumidor: começar pelos dados de substituição
A metodologia que resolve todos os problemas das CDTs herdadas parte de outra pergunta. Em vez de perguntar “como devemos categorizar esses produtos?”, pergunte: “Quais produtos os shoppers realmente tratam como substitutos entre si?”
A base são os dados de transações do PDV: os registros reais de compra do que os shoppers levaram nas cestas e nas visitas ao longo do tempo. Em vez de impor uma hierarquia baseada em atributos de produto ou em informações de fornecedores, os gerentes de categoria deixam que os padrões de coocorrência nos dados definam a estrutura.
A árvore que surge reflete como os shoppers se comportam quando a primeira escolha não está disponível ou quando estão avaliando as opções dentro de uma categoria. Essa CDT não parte de como um fornecedor acha que eles deveriam se comportar, nem de como a categoria estava organizada num workshop de reset dois anos atrás.
Em vez de impor uma hierarquia baseada em atributos de produto ou em informações de fornecedores, os gerentes de categoria deixam que os padrões de coocorrência nos dados definam a estrutura.
Na prática, a hierarquia resultante costuma surpreender. Uma árvore criada por um fornecedor para uma categoria de cuidados pessoais pode colocar a marca no alto da hierarquia, embora os dados de transações possam contar uma história diferente. A forma de aplicação pode pesar mais para os shoppers do que a marca quando a primeira escolha está em ruptura.
Por exemplo, um shopper pode escolher outra marca de desodorante antes de trocar o roll-on pelo spray. Se um padrão como esse se mantém de forma consistente em milhares de transações, ele deve estar refletido na árvore, em vez de ser construído a partir de atributos de produto ou de informações do fornecedor.
O princípio por trás disso é simples. A CDT deve refletir o comportamento puro do consumidor, e o conhecimento da categoria serve para explicar e nomear o que os dados revelam. Os dados definem a estrutura; o gerente de categoria a interpreta, dá nome aos nós e a torna utilizável.
Por que as CDTs baseadas em substituição geram resultados de sortimento melhores
A vantagem imediata das CDTs baseadas em substituição é a cobertura. Sem uma árvore precisa, os itens mais vendidos de uma categoria tendem a se concentrar em um ou dois nós. O otimizador de sortimento, trabalhando corretamente a partir da estrutura que recebe, preenche bem esses nós. O resultado é mais profundidade onde já ia tudo bem e nada onde faltava cobertura. Uma árvore baseada em substituição distribui os nós com mais precisão pelo perfil real da demanda dos shoppers, e assim o otimizador protege o que realmente importa.
A segunda vantagem é que dados de coocorrência em escala transacional são difíceis de contestar, ao contrário da CDT de um fornecedor. Uma hierarquia criada por fornecedor pode ser questionada com base na intuição, mas padrões consistentes de coocorrência em centenas de milhares de cestas são mais difíceis de descartar. Quando os dados revelam algo inesperado, geralmente apontam para algo que o último workshop de categoria deixou passar — e é justamente esse o ponto.
A terceira é a escalabilidade. Uma CDT construída manualmente é o esforço de uma pessoa, feito uma vez por categoria a cada ciclo e limitado pela quantidade de categorias que essa pessoa consegue cobrir em um ano. Um modelo que identifica padrões de coocorrência nos dados de transações pode rodar em muitas categorias ao mesmo tempo, com o profissional revisando e validando o resultado em vez de construir do zero. O trabalho passa da construção para o questionamento, o que é um uso melhor da expertise de categoria.
O que é necessário para construir uma árvore de decisão do consumidor com dados de comportamento do shopper
Construir uma CDT baseada em comportamento vai além da escolha de uma metodologia. Ela tem alguns requisitos práticos de dados e de tecnologia.
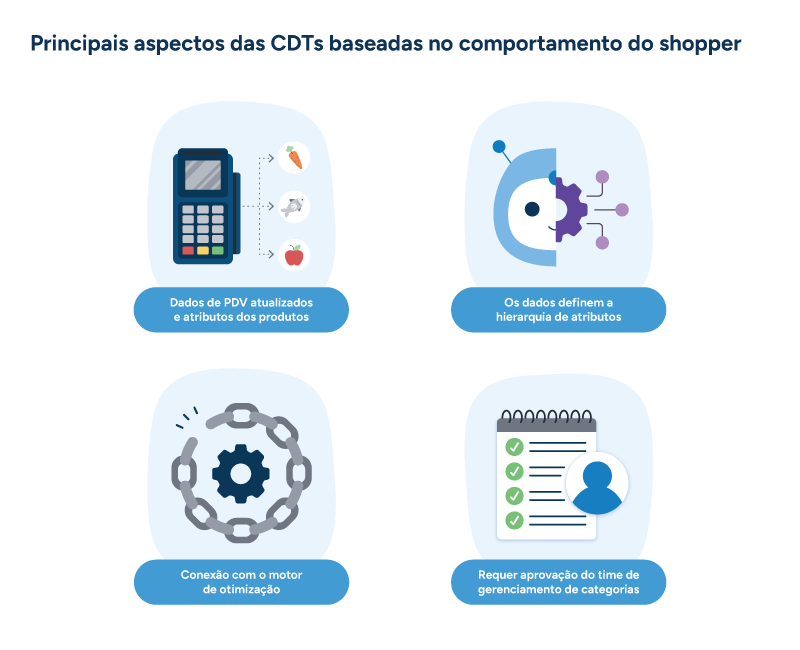
Dados de PDV atualizados, no nível da cesta, e atributos de produto
A base é formada por duas coisas que trabalham juntas:
- Dados de transações que registram o que os shoppers compraram nas cestas e nas visitas ao longo do tempo
- Uma exportação limpa de atributos de produto, que descreve as propriedades de cada SKU (formato, marca, sabor, faixa de preço etc.)
O sinal de substituição vem dos padrões de compra individuais, e não dos totais da categoria, portanto dados agregados de vendas não bastam. O modelo precisa das duas entradas para identificar quais atributos explicam as diferenças entre produtos que os shoppers tratam como substitutos.
Um modelo treinado que classifica atributos por poder explicativo
A principal diferença entre uma árvore baseada em comportamento e uma convencional está em como a hierarquia é determinada.
Em uma CDT tradicional, alguém decide de antemão que a marca fica acima do formato, ou o formato acima do tamanho, com base em julgamento ou convenção.
Em uma abordagem baseada em padrões de coocorrência, um modelo treinado lê os dados de transações do cliente e decide quais atributos usar nas divisões e em que ordem. A decisão se baseia no quanto cada atributo explica as diferenças entre os produtos em cada ramificação.
O resultado é uma hierarquia derivada do comportamento real dos shoppers. Os produtos que caem no mesmo nó-folha são, por essa lógica, tratados como substitutos: aquilo que o shopper busca quando a primeira escolha não está disponível.
Uma conexão direta com o motor de otimização
Uma CDT que fica isolada do processo de planejamento de sortimento resolve apenas parte do problema. As decisões downstream, como “quais produtos são essenciais?”, “quais são opcionais?” e “o que deve ser racionalizado?”, precisam herdar a mesma lógica de shopper em que a árvore se baseou.
Quando a CDT alimenta diretamente o motor de otimização de sortimento de um sistema de planejamento, a estrutura da árvore se reflete em todas as decisões de sortimento. O otimizador passa a usar cada nó terminal como uma restrição de cobertura. Isso garante que o sortimento tenha pelo menos um produto para cada necessidade do consumidor, em vez de ser preenchido a partir de totais agregados da categoria.
Um modelo de ativação que mantém o profissional no controle
Um modelo que gera árvores de decisão automaticamente e as coloca em uso sem revisão cria outro problema. Os gerentes de categoria perdem a visibilidade sobre o que mudou e por quê, e a confiança se desgasta rápido.
A abordagem certa é gerar as novas árvores como inativas por padrão. Isso significa que nada entra em operação até que um gerente de categoria revise o resultado, dê nome aos nós, valide os grupos de substituição diante da realidade comercial e aprove a atualização de forma explícita. É a parte da metodologia mais fácil de subestimar, mas também a que faz o resto funcionar.
Os gerentes de categoria que trabalham assim sabem bem como essa experiência precisa ser. A ideia é sentar, entrar no clima certo e sentir que está fazendo a sua CDT, e não descobrir que ela já foi feita em seu lugar. O modelo roda de forma agendada; o gerente de categoria decide quando a nova versão entra em operação.
O papel do julgamento passa de construir uma árvore a partir de uma folha em branco para questionar o que os dados encontraram e decidir em quais partes confiar. É um uso mais produtivo da expertise de categoria do que a classificação manual de atributos.
Como o RELEX CDT Builder coloca essa metodologia em prática
O RELEX CDT Builder reúne as entradas de dados, a abordagem de modelagem e o modelo de ativação que a construção de CDTs baseadas em comportamento exige. Ele faz parte do RELEX Assortment Planning, que integra a plataforma unificada da RELEX e permite conectar as decisões de sortimento ao planejamento de espaço, demanda e reabastecimento.
O processo usa um modelo de tópicos treinado para aprender padrões de comportamento a partir dos dados de cesta. Uma execução típica de construção leva alguns minutos por categoria e pode ser configurada no nível da categoria. Os gerentes de categoria podem controlar a profundidade máxima da árvore, o tamanho mínimo dos nós e quais atributos devem ou não aparecer em todos os caminhos.
A árvore gerada se conecta diretamente ao Assortment Optimizer, no qual cada nó terminal funciona como uma restrição de cobertura. O otimizador garante que o sortimento tenha pelo menos um produto por necessidade do consumidor, de modo que a profundidade nos nós que já vão bem e a cobertura dos nós subatendidos sejam gerenciadas em conjunto, e não uma contra a outra. Os gerentes de categoria revisam e nomeiam o resultado, validam os grupos de substituição com base no conhecimento que têm da categoria e ativam a árvore quando estão satisfeitos. Assim, mantêm o controle total sobre o que entra em operação e quando.
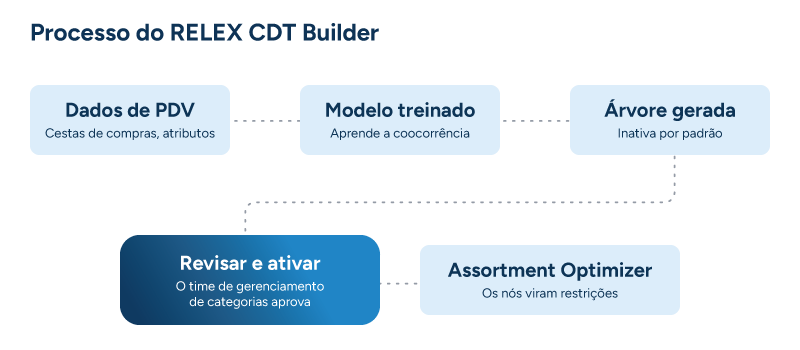
Para times que gerenciam portfólios de categorias grandes ou complexos, o ganho de escalabilidade é significativo. O CDT Builder roda em muitas categorias ao mesmo tempo, e os gerentes de categoria revisam e validam o resultado em vez de construir do zero. O trabalho passa da construção para o questionamento, e as categorias que antes esperariam meses por uma reconstrução manual passam a ser atualizadas em ciclos definidos pelo modelo.
A direção de longo prazo parte dessa base. A previsão que leva em conta a transferência de demanda, incluindo a previsão de novos produtos por meio da atribuição de nós da CDT, vai estender essa mesma lógica baseada em comportamento, das decisões de sortimento para o processo de planejamento como um todo.
Faça valer a pena a próxima reconstrução da sua CDT
A maioria dos gerentes de categoria trabalha com uma CDT que outra pessoa construiu, usando um método que fazia sentido na época e que hoje precisa, com urgência, de uma atualização. A questão é se a próxima versão será construída com base em como os shoppers realmente se comportam ou nas mesmas suposições da última.
Para quem está pronto para fazer essa mudança, o RELEX Assortment Planning é o próximo passo prático. Construída sobre a metodologia baseada em substituição, essa solução foi pensada para devolver aos gerentes de categoria o controle da estrutura de que seus sortimentos dependem.
Escrito por
Artigos relacionados
IA Agêntica no planejamento da cadeia de suprimentos industrial
Veja como a IA Agêntica ajuda fabricantes a revisar previsões, resolver restrições e testar planos sob estresse, com agentes gerais e sob medida no RELEX Open.
Mais do que leite: laticínios pedem uma virada de chave no planejamento
Saiba como a RELEX ajuda o setor de laticínios a aproveitar grandes oportunidades, ampliar a diversificação e ganhar eficiência e lucratividade.
7 formas como o planejamento com IA resolve os desafios da cadeia de suprimentos na indústria da carne
Descubra sete capacidades de planejamento de cadeia de suprimentos com IA que ajudam a fechar a lacuna de margem na indústria de carne vermelha.