Cómo crear un árbol de decisión del consumidor: por qué los mejores CDT parten del comportamiento de compra y no de la lógica de suministro
Nov 6, 2026 • 13 min.
Crear un árbol de decisión del consumidor parece bastante sencillo, hasta que alguien pregunta: “¿Quién lo creó?” y “¿Cómo lo hicieron?”.
La mayoría de los responsables de categoría no crearon su CDT. Lo heredaron de un proveedor de marca, de una consultora o de un equipo interno de categoría que hace tiempo pasó a otros proyectos. Aun así, desde entonces optimizan dentro de esa estructura. Cada año actualizan los productos, debaten los nombres de los nodos y realizan revisiones del surtido sobre una estructura que alguien creó una sola vez, por motivos que quizá ya no se aplican.
Esto importa más de lo que parece. Un árbol de decisión del consumidor es la base de todas las decisiones de surtido que toma un retailer. Determina qué productos se seleccionan o no según las distintas necesidades del consumidor, para garantizar la amplitud y la profundidad adecuadas de un surtido óptimo.
Si la estructura es errónea, un retailer puede obtener buenos resultados en todas las métricas financieras mientras deja sin atender, sin hacer ruido, una necesidad completa del consumidor. No saltará ninguna alerta en los datos, porque el árbol no refleja cómo toman decisiones los compradores en realidad.
Actualizar el árbol de decisión existente no basta. La solución es crear el siguiente a partir del comportamiento real de compra, captado en cómo aparecen juntos los productos en las compras y las visitas a lo largo del tiempo.
Cómo se crean hoy los árboles de decisión del consumidor (CDT)
Hay varias formas habituales en las que los responsables de categoría llegan a un árbol de decisión del consumidor. Cada una se crea a su manera, pero todas comparten la misma limitación fundamental: estos árboles capturan una única instantánea que permanece fija mientras la categoría sigue su curso.
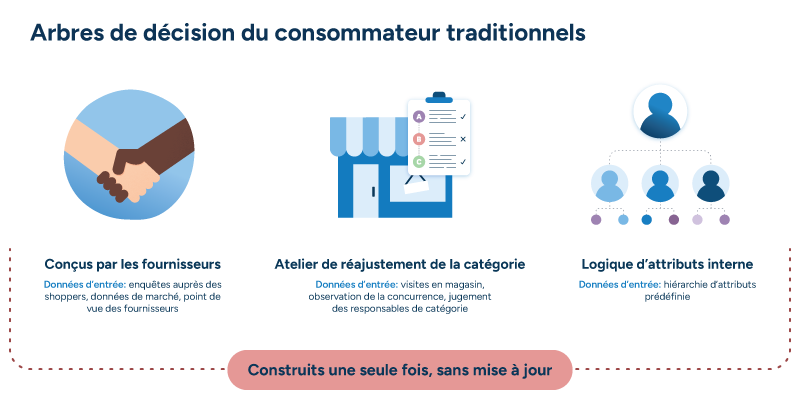
Árboles creados por proveedores
Es la fuente más habitual de CDT. Los proveedores de marca y las consultoras de gestión por categorías ofrecen un conocimiento real de las categorías y capacidades de investigación que la mayoría de los retailers no tienen internamente, lo que los convierte en una opción natural para este tipo de trabajo. La investigación suele combinar encuestas a compradores, datos de mercado y experiencia en la categoría para obtener una jerarquía de atributos ordenados según la secuencia en que el proveedor cree que los compradores toman sus decisiones.
El árbol resultante muestra qué productos van juntos y cómo debe recorrerse la categoría, desde el nodo de categoría de nivel superior hasta los SKU individuales del nivel de hoja (los nodos más bajos).
Talleres de reestructuración de categorías
La alternativa para los retailers que crean sus propios CDT es el taller de reestructuración de categorías. Las visitas a tiendas, la observación de la competencia y el criterio de los responsables de categoría se combinan en un ejercicio estructurado que aprovecha el conocimiento directo de la categoría durante un único período. El resultado es una jerarquía creada a partir de la observación directa de cómo se organizan las categorías en el mercado. Una jerarquía interpretada desde la experiencia del equipo de categoría y contrastada con datos de ventas para validar la estructura.
Lógica interna de atributos
El tercer enfoque es el que a menudo no se examina. Los árboles de decisión se crean a partir de jerarquías de atributos de producto que el equipo de categoría define internamente según cómo está organizada la categoría. Los atributos se ordenan en una secuencia que refleja cómo entiende la categoría el equipo, y los productos se asignan a los nodos según el lugar que sus atributos les otorgan en esa jerarquía.
Los atributos que se ordenan pueden incluir:
- Marca;
- Tamaño;
- Formato;
- Sabor;
- Nivel de precio.
Cada nodo del nivel más bajo contiene entonces los productos que comparten la misma ruta de atributos, de arriba abajo del árbol.
¿Por qué los CDT heredados dejan sin atender las necesidades del consumidor?
Cada uno de los métodos habituales de creación de CDT tiene su propio defecto concreto, pero todos tienen la misma consecuencia, sea cual sea el modo en que se creó el árbol. El CDT determina qué se protege. Si una necesidad del consumidor no está representada en el árbol, el sistema no tiene forma de señalar su ausencia. Simplemente completa el surtido con los nodos que sí existen, y la brecha sigue siendo invisible.
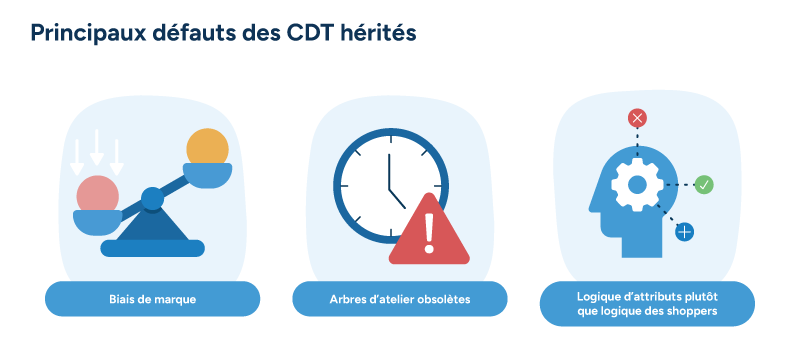
El sesgo del proveedor sitúa la marca en lo más alto
Cuando la marca ocupa un lugar alto en la jerarquía porque un proveedor la puso ahí, el árbol refleja las prioridades del proveedor y no las decisiones de los compradores. Un comprador cuyo primer criterio es la ocasión, el formato o el país de origen recorrerá la categoría en una secuencia que el árbol no modela. El surtido puede parecer completo según la lógica del árbol y, aun así, desatender sistemáticamente a los compradores que no empiezan por la marca. No existe ningún mecanismo para detectar ese problema, porque el propio árbol define lo que significa “completo”.
Los árboles de taller se quedan obsoletos
Un taller de reestructuración de categorías produce una instantánea. Esto es útil a corto plazo, pero el comportamiento de compra cambia, surgen nuevos formatos, la dinámica competitiva se transforma y la marca propia crece, y el árbol no se mueve con ellos. Puede que el responsable de categoría intuya que algo no encaja, pero el CDT no lo confirma, porque se creó para reflejar un momento que ya está desfasado. Actualizarlo implica repetir el taller, lo que a su vez supone esperar al siguiente ciclo para hacer los ajustes necesarios.
La lógica de atributos confunde organización con insight
Un árbol creado a partir de atributos de producto (como marca, tamaño, sabor o formato) refleja cómo está organizada la categoría en una base de datos, no necesariamente cómo recorre un comprador una decisión. Ambos pueden parecerse sobre el papel, pero divergen notablemente en la práctica. Si un comprador opta por otra marca antes de cambiar de un formato a otro, pero el árbol sitúa la marca por encima del formato, la jerarquía está invertida respecto al comportamiento real. Las decisiones de surtido que se tomen a partir de ahí se optimizarán según una lógica errónea.
La mejor forma de crear un árbol de decisión del consumidor: partir de los datos de sustitución
La metodología que aborda todos los problemas de los CDT heredados parte de una pregunta distinta. En lugar de preguntarse “¿cómo deberíamos categorizar estos productos?”, hay que preguntarse: “¿qué productos tratan realmente los compradores como sustitutos entre sí?”.
La entrada son los datos de transacciones del punto de venta (POS): los registros reales de lo que compraron los compradores en las compras y las visitas a lo largo del tiempo. En lugar de imponer una jerarquía basada en los atributos de los productos o en las aportaciones de los proveedores, los responsables de categoría dejan que los patrones de coocurrencia de los datos definan la estructura.
El árbol que surge refleja cómo se comportan los compradores cuando su primera opción no está disponible o cuando sopesan opciones dentro de una categoría. Este CDT no se basa en cómo cree un proveedor que deberían comportarse, ni en el aspecto que tenía la categoría en un taller de reestructuración hace dos años.
En lugar de imponer una jerarquía basada en los atributos de los productos o en las aportaciones de los proveedores, los responsables de categoría dejan que los patrones de coocurrencia de los datos definan la estructura.
En la práctica, la jerarquía que resulta suele sorprender. Un árbol creado por un proveedor para una categoría de cuidado personal podría situar la marca en un nivel alto de la jerarquía, aunque los datos de transacciones pueden contar una historia distinta. El método de aplicación puede importar más a los compradores que la marca cuando su primera opción no está en stock.
Por ejemplo, un comprador podría optar por otra marca de desodorante antes de pasar del roll-on al spray. Si un patrón así se mantiene de manera consistente en miles de transacciones, debería reflejarse en el árbol y no construirse a partir de atributos de producto o de aportaciones de proveedores.
El principio de fondo es sencillo. El CDT debería reflejar el comportamiento puro del consumidor, y el conocimiento de la categoría debería servir para explicar y nombrar lo que muestran los datos. Los datos definen la estructura; el responsable de categoría la interpreta, da nombre a los nodos y la hace utilizable.
Por qué los CDT basados en la sustitución generan mejores resultados de surtido
La ventaja inmediata de los CDT basados en la sustitución es la cobertura. Sin un árbol preciso, los productos más vendidos de una categoría tienden a concentrarse en uno o dos nodos. El optimizador de surtido, que trabaja correctamente a partir de la estructura que se le da, completa bien esos nodos, lo que supone profundidad en las áreas que ya ganaban y nada en las áreas que necesitaban cobertura. Un árbol basado en la sustitución distribuye los nodos con más exactitud a lo largo de la forma real de la demanda de los compradores, de modo que el optimizador protege lo que corresponde.
La segunda ventaja es que los datos de coocurrencia a escala de transacciones son difíciles de rebatir, a diferencia del CDT de un proveedor. Una jerarquía creada por un proveedor puede cuestionarse por intuición, pero los patrones de coocurrencia consistentes en cientos de miles de compras son más difíciles de descartar. Cuando los datos revelan algo inesperado, suele ser señal de algo que el último taller de categoría pasó por alto, y de eso se trata.
La tercera es la escalabilidad. Un CDT creado manualmente es el esfuerzo de una sola persona, realizado una vez por categoría y por ciclo, y limitado por cuántas categorías puede abarcar esa persona en un año. Un modelo que identifica patrones de coocurrencia a partir de datos de transacciones puede ejecutarse en muchas categorías simultáneamente, y el profesional revisa y valida el resultado en lugar de crearlo desde cero. El trabajo pasa de la construcción al análisis crítico, que es un mejor uso de la experiencia en la categoría.
Qué se necesita para crear un árbol de decisión del consumidor a partir de datos del comportamiento de compra
Crear un CDT basado en el comportamiento es más que elegir una metodología. Exige ciertos requisitos prácticos de datos y de tecnología.
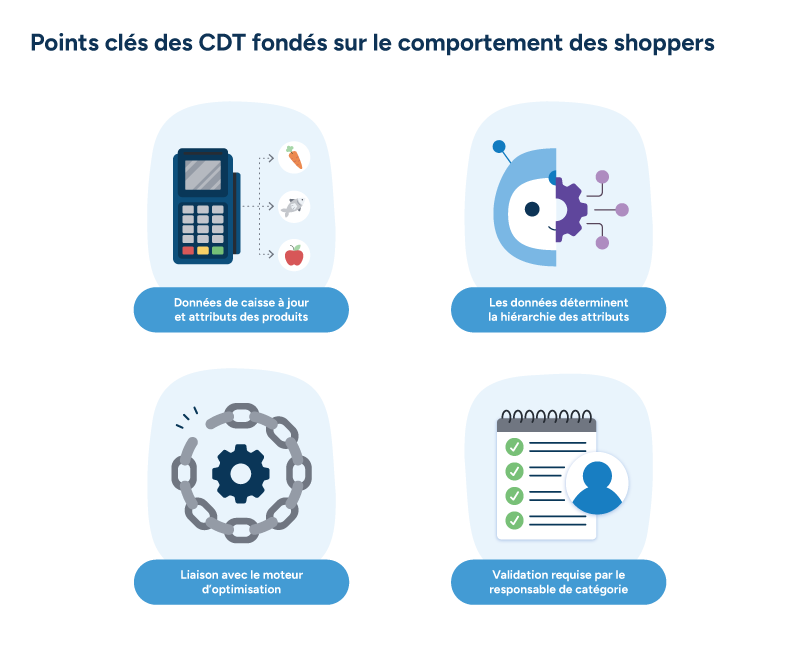
Datos POS actualizados a nivel de compra y atributos de producto
La base consta de dos elementos que funcionan conjuntamente:
- Datos de transacciones que recogen lo que compraron los compradores en las compras y las visitas a lo largo del tiempo;
- Una exportación limpia de atributos de producto que describa las propiedades de cada SKU (formato, marca, sabor, nivel de precio, etc.).
La señal de sustitución procede de los patrones de compra individuales, no de los totales por categoría, por lo que los datos de ventas agregados no bastan. El modelo necesita ambas entradas para identificar qué atributos explican las diferencias entre los productos que los compradores tratan como sustitutos.
Un modelo entrenado que ordena los atributos por su poder explicativo
La diferencia clave entre un árbol basado en el comportamiento y uno convencional está en cómo se determina la jerarquía.
En un CDT tradicional, alguien decide de antemano que la marca va por encima del formato, o el formato por encima del tamaño, según su criterio o por convención.
En un enfoque basado en patrones de coocurrencia, un modelo entrenado lee los datos de transacciones del cliente y decide por qué atributos dividir y en qué orden. La decisión se basa en lo bien que cada atributo explica las diferencias entre productos en cada rama.
El resultado es una jerarquía derivada del comportamiento real de compra. Los productos que acaban en el mismo nodo hoja se tratan, según esa lógica, como sustitutos: lo que el comprador busca cuando su primera opción no está disponible.
Una conexión directa con el motor de optimización
Un CDT aislado del proceso de planeación de surtido solo resuelve una parte del problema. Las decisiones posteriores, como “¿qué productos son esenciales?”, “¿cuáles son opcionales?” y “¿qué se optimiza?”, deben heredar la misma lógica de comprador con la que se creó el árbol.
Cuando el CDT alimenta directamente el motor de optimización de surtido de un sistema de planeación, la estructura del árbol se transmite a todas las decisiones de surtido. El optimizador puede entonces usar cada nodo terminal como restricción de cobertura. Así se garantiza que el surtido contenga al menos un producto por cada necesidad del consumidor, en lugar de completarlo a partir de los totales agregados de la categoría.
Un modelo de activación que mantiene el control en manos del profesional
Un modelo que genera árboles de decisión automáticamente y los despliega sin revisión crea un problema distinto. Los responsables de categoría pierden visibilidad sobre qué ha cambiado y por qué, y la confianza se erosiona rápidamente.
El enfoque adecuado es generar los árboles nuevos como inactivos por defecto. Es decir, nada entra en funcionamiento hasta que un responsable de categoría revise el resultado, etiquete los nodos, valide los grupos de sustitución frente a la realidad comercial y apruebe explícitamente la actualización. Es la parte de la metodología más fácil de subestimar, pero también la que hace que todo lo demás funcione.
Los responsables de categoría que trabajan así tienen claro cómo debe sentirse. El objetivo es sentarse, estar con la disposición adecuada y sentir que es el responsable de categoría quien hace su CDT, no descubrir que ya se lo han hecho. El modelo se ejecuta según un calendario; el responsable de categoría decide cuándo entra en funcionamiento la nueva versión.
El papel del criterio pasa de crear un árbol desde cero a cuestionar lo que han encontrado los datos y decidir qué partes merecen confianza. Es un uso más productivo de la experiencia en la categoría que la clasificación manual de atributos.
Cómo aplica RELEX CDT Builder esta metodología en la práctica
RELEX CDT Builder reúne las entradas de datos, el enfoque de modelización y el modelo de activación que requiere la creación de CDT basados en el comportamiento. Forma parte de RELEX Assortment Planning, que se integra en la plataforma unificada de RELEX y permite que las decisiones de surtido se conecten con la planeación del espacio, de la demanda y del reabastecimiento.
El proceso usa un modelo de temas entrenado para aprender patrones de comportamiento a partir de los datos de compra. Una ejecución típica tarda unos minutos por categoría y puede configurarse a nivel de categoría. Los responsables de categoría pueden controlar la profundidad máxima del árbol, el tamaño mínimo de los nodos y qué atributos deben o no deben aparecer en cada ruta.
El árbol que genera se conecta directamente con Assortment Optimizer, donde cada nodo terminal funciona como restricción de cobertura. El optimizador garantiza que el surtido contenga al menos un producto por cada necesidad del consumidor, de modo que la profundidad en los nodos ganadores y la cobertura de los desatendidos se gestionan conjuntamente y no en tensión. Los responsables de categoría revisan y etiquetan el resultado, validan los grupos de sustitución con su conocimiento de la categoría y activan el árbol cuando están satisfechos. Esto les permite mantener el control total sobre qué entra en funcionamiento y cuándo.
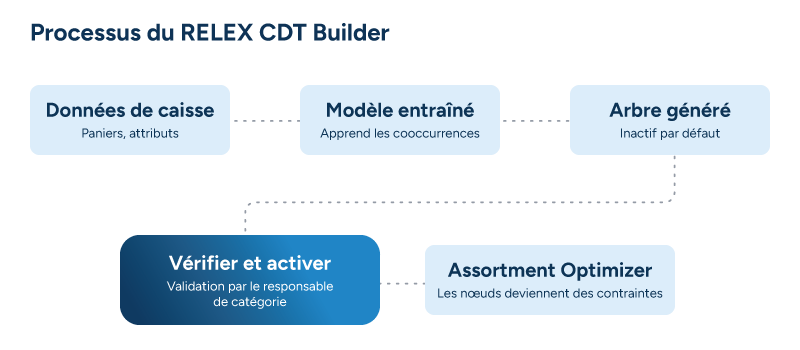
Para los equipos que gestionan carteras de categorías grandes o complejas, el cambio en escalabilidad es significativo. CDT Builder se ejecuta en muchas categorías simultáneamente, y los responsables de categoría revisan y validan el resultado en lugar de crearlo desde cero. El trabajo pasa de la construcción al análisis crítico, y las categorías que antes habrían esperado meses a una reconstrucción manual se actualizan ahora según un calendario basado en el modelo.
La dirección a largo plazo se apoya en esta base. La previsión que tiene en cuenta la transferencia de demanda, incluida la previsión de productos nuevos mediante la asignación de nodos del CDT, extenderá la misma lógica basada en el comportamiento, de las decisiones de surtido al conjunto del proceso de planeación.
Lograr que la próxima reconstrucción del CDT cuente
La mayoría de los responsables de categoría trabajan con un CDT que creó otra persona, con un método que tenía sentido en su momento y que ahora necesita urgentemente una actualización. La cuestión es si la próxima versión se basará en cómo se comportan realmente los compradores o en las mismas suposiciones que la anterior.
Para quienes están listos para dar ese salto, RELEX Assortment Planning es el siguiente paso práctico. Basada en la metodología de sustitución, esta solución está diseñada para devolver a los responsables de categoría el control de la estructura de la que dependen sus surtidos.
Autor
Artículos relacionados
IA agéntica en la planeación de la cadena de suministro de fabricación
Conozca cómo la IA agéntica permite a los fabricantes revisar previsiones, resolver restricciones y probar planes con agentes generales y a medida en RELEX Open.
7 formas en que el software de planeación con IA resuelve los retos de la cadena de suministro de la industria cárnica
Descubra siete capacidades de planeación con IA que reducen la brecha de margen en la fabricación de carne roja
Estudio de caso: Grupo Vinoteca
Descubra cómo Grupo Vinoteca redujo un 34,7 % las ventas perdidas y agilizó el reabastecimiento en tienda con la planeación inteligente y basada en IA de RELEX.