Consumer Decision Tree erstellen: warum die besten CDTs beim Shopper-Verhalten ansetzen und nicht beim Angebot
Nov 3, 2026 • 10 min
Einen Consumer Decision Tree zu erstellen, klingt unkompliziert, bis jemand nachfragt: „Wer hat ihn erstellt?“ und „Wie ist er überhaupt entstanden?“
Die meisten Category Manager haben ihren CDT nicht selbst erstellt. Sie haben ihn von einem Markenlieferanten, einer Beratung oder einem internen Category-Team übernommen, das längst weitergezogen ist. Trotzdem optimieren sie seither innerhalb dieser Struktur: Sie aktualisieren jedes Jahr die Produkte, diskutieren über Knotenbezeichnungen und gleichen Sortimentsüberprüfungen mit einer Struktur ab, die irgendwann mal von jemand anderem aufgebaut wurde, und zwar aus Gründen, die vielleicht nicht mehr gelten.
Das ist noch wichtiger, als es klingt. Ein Consumer Decision Tree bildet die Grundlage jeder Sortimentsentscheidung im Handel. Er bestimmt, welche Produkte über unterschiedliche Konsumentenbedürfnisse hinweg ins Sortiment kommen und welche nicht, damit Breite und Tiefe des Sortiments optimal ausfallen.
Stimmt die Struktur nicht, kann ein Händler bei jeder Finanzkennzahl gut abschneiden und dabei unbemerkt ein ganzes Konsumentenbedürfnis unbedient lassen. In den Daten tauchen keine Warnsignale auf, weil der CDT nicht abbildet, wie Shopper tatsächlich Kaufentscheidungen treffen.
Den bestehenden CDT zu aktualisieren, reicht nicht aus. Die Lösung besteht darin, den nächsten CDT aus dem tatsächlichen Shopper-Verhalten abzuleiten, also daraus, wie Produkte im Zeitverlauf gemeinsam in Warenkörben und bei Einkäufen auftreten.
So werden Consumer Decision Trees (CDTs) heute erstellt
Category Manager gelangen auf einigen gängigen Wegen zu einem Consumer Decision Tree. Jeder Weg funktioniert anders, doch alle teilen dieselbe grundlegende Schwäche: Das Ergebnis ist eine einzelne Momentaufnahme, die bleibt, während sich die Kategorie weiterentwickelt.
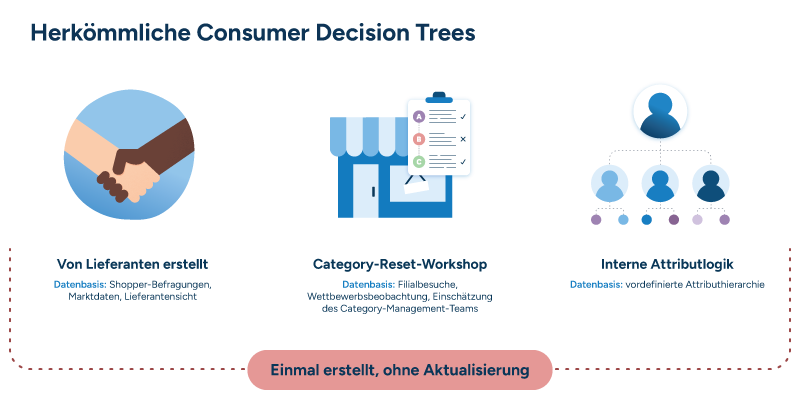
Von Lieferanten erstellte CDTs
Das ist die häufigste Quelle für CDTs. Markenlieferanten und auf Category Management spezialisierte Beratungen bringen echtes Kategoriewissen und Marktforschungskompetenz mit, die den meisten Händlern intern fehlt. Dafür sind sie eine naheliegende Wahl. In der Regel verbinden die Analysen Shopper-Befragungen, Marktdaten und Category-Expertise zu einer Attributhierarchie, die in der Reihenfolge angeordnet ist, in der die Lieferanten vermuten, dass Shopper ihre Entscheidungen treffen.
Der entstehende CDT legt fest, welche Produkte zusammengehören und wie die Kategorie zu durchlaufen ist: vom Knoten der obersten Kategorieebene bis zu den einzelnen SKUs auf Ebene der Endknoten (den untersten Knoten).
Category-Reset-Workshops
Die Alternative für Händler, die ihre CDTs selbst erstellen, ist der Category-Reset-Workshop. Filialbesuche, Wettbewerbsbeobachtung und die Einschätzung der Category Manager fließen in eine strukturierte Übung ein, die in einem einzelnen Zeitfenster auf Kategoriewissen aus erster Hand zurückgreift. Das Ergebnis ist eine Hierarchie, die auf der direkten Beobachtung beruht, wie Kategorien im Markt aufgebaut sind. Sie wird durch die Expertise des Category-Teams interpretiert und mit Abverkaufsdaten abgeglichen, um die Struktur zu validieren.
Interne Attributlogik
Der dritte Ansatz wird oft nicht hinterfragt. Hier werden CDTs aus Hierarchien von Produktattributen aufgebaut, die das Category-Team intern danach festlegt, wie die Kategorie organisiert ist. Die Attribute werden in eine Rangfolge gebracht, die widerspiegelt, wie das Team die Kategorie versteht, und die Produkte werden den Knoten zugeordnet, an denen ihre Attribute sie in dieser Hierarchie verorten.
Zu den Attributen in dieser Rangfolge können gehören:
- Marke
- Größe
- Format
- Geschmacksrichtung
- Preislage
Jeder Knoten der untersten Ebene enthält dann die Produkte, die denselben Attributpfad von der Spitze bis zum Ende des Baums teilen.
Warum lassen übernommene CDTs Konsumentenbedürfnisse unbedient?
Jede der üblichen Erstellungsmethoden hat ihre eigene Schwäche, doch die Folge ist immer dieselbe, unabhängig davon, wie der CDT aufgebaut wurde: Der CDT bestimmt, was geschützt wird. Ist ein Konsumentenbedürfnis in der Struktur nicht abgebildet, kann das System sein Fehlen nicht anzeigen. Es füllt das Sortiment schlicht aus den vorhandenen Knoten auf, und die Lücke bleibt unsichtbar.
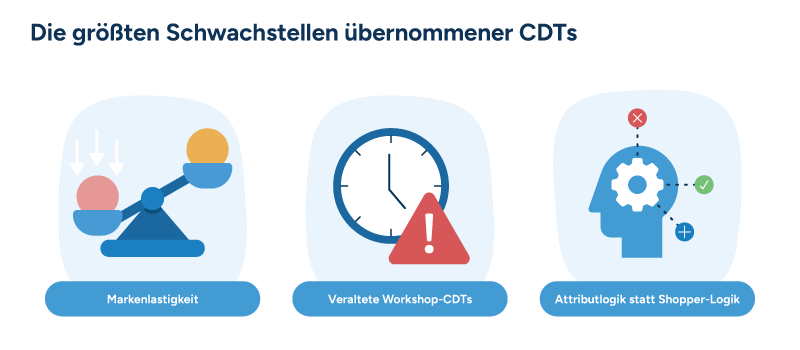
Der Einfluss der Lieferanten schiebt die Marke an die Spitze
Steht die Marke oben in der Hierarchie, weil ein Lieferant sie dort platziert hat, spiegelt der CDT die Prioritäten der Lieferanten wider und nicht die Entscheidungen der Shopper. Shopper, deren erstes Kriterium Anlass, Format oder Herkunftsland ist, durchlaufen die Kategorie in einer Reihenfolge, die der CDT nicht abbildet. Nach der Logik des CDT kann das Sortiment umfassend wirken, obwohl Shopper, die nicht mit der Marke einsteigen, systematisch unterversorgt bleiben. Es gibt keinen Mechanismus, der dieses Problem sichtbar macht, denn der CDT selbst definiert, was „umfassend“ bedeutet.
Workshop-CDTs veralten
Ein Category-Reset-Workshop liefert eine Momentaufnahme. Kurzfristig ist das nützlich, doch das Shopper-Verhalten verändert sich, neue Formate entstehen, die Wettbewerbsdynamik verschiebt sich und Eigenmarken legen zu, nur der CDT bewegt sich nicht mit. Category Manager spüren vielleicht, dass etwas nicht stimmt, aber der CDT bestätigt es nicht, weil er einen Moment abbilden sollte, der inzwischen überholt ist. Um ihn zu aktualisieren, muss der Workshop erneut stattfinden. Das heißt, bis zum nächsten Zyklus zu warten, bevor die nötigen Anpassungen möglich sind.
Attributlogik verwechselt Organisation mit Erkenntnis
Ein CDT, der aus Produktattributen (etwa Marke, Größe, Geschmacksrichtung oder Format) aufgebaut ist, bildet ab, wie die Kategorie in einer Datenbank organisiert ist, und nicht unbedingt, wie Shopper eine Entscheidung durchlaufen. Auf dem Papier können beide Strukturen ähnlich aussehen, in der Praxis weichen sie jedoch erheblich voneinander ab. Greifen Shopper zu einer anderen Marke, bevor sie das Format wechseln, der CDT aber die Marke über dem Format einordnet, steht die Hierarchie im Verhältnis zum tatsächlichen Verhalten auf dem Kopf. Die darauf aufbauenden Sortimentsentscheidungen werden dann an der falschen Logik optimiert.
Der bessere Weg zum Consumer Decision Tree: mit Substitutionsdaten beginnen
Die Methode, die alle Probleme übernommener CDTs löst, beginnt mit einer anderen Frage. Fragen Sie nicht: „Wie sollen wir diese Produkte kategorisieren?“, sondern: „Welche Produkte betrachten Shopper tatsächlich als Substitute füreinander?“
Grundlage sind POS-Transaktionsdaten: die tatsächlichen Kaufdaten darüber, was Shopper im Zeitverlauf in Warenkörben und bei Einkäufen gekauft haben. Statt eine Hierarchie auf Basis von Produktattributen oder Lieferantenvorgaben vorzugeben, lassen Category Manager die Struktur durch Co-Occurrence-Muster in den Daten bestimmen.
Der CDT, der so entsteht, zeigt, wie sich Shopper verhalten, wenn ihre erste Wahl nicht verfügbar ist oder sie innerhalb einer Kategorie Optionen abwägen. Er beruht nicht darauf, wie ein Lieferant glaubt, dass sich Shopper verhalten sollten, oder darauf, wie die Kategorie bei einem Category-Reset-Workshop vor zwei Jahren aussah.
Statt eine Hierarchie auf Basis von Produktattributen oder Lieferantenvorgaben vorzugeben, lassen Category Manager die Struktur durch Co-Occurrence-Muster in den Daten bestimmen.
In der Praxis fällt die so entstehende Hierarchie oft überraschend aus. Ein vom Lieferanten erstellter CDT für eine Körperpflegekategorie platziert die Marke womöglich weit oben, obwohl die Transaktionsdaten eine andere Geschichte erzählen können. Die Anwendungsform kann Shoppern wichtiger sein als die Marke, wenn ihre erste Wahl nicht vorrätig ist.
So greifen Shopper bei Deodorants womöglich eher zu einer anderen Marke, bevor sie von Roll-on auf Spray wechseln. Zeigt sich ein solches Muster durchgängig in Tausenden von Transaktionen, sollte es sich im CDT widerspiegeln, statt ihn aus Produktattributen oder Lieferantenvorgaben aufzubauen.
Das zugrunde liegende Prinzip ist einfach. Der CDT soll reines Konsumentenverhalten abbilden, und das Kategoriewissen dient dazu, zu erklären und zu benennen, was die Daten zutage fördern. Die Daten bestimmen die Struktur. Category Manager interpretieren sie, benennen die Knoten und machen sie nutzbar.
Warum substitutionsbasierte CDTs zu besseren Sortimentsergebnissen führen
Der unmittelbare Vorteil substitutionsbasierter CDTs ist die Abdeckung. Ohne einen präzisen CDT konzentrieren sich die Topseller einer Kategorie meist in ein oder zwei Knoten. Die Sortimentsoptimierung arbeitet korrekt mit der Struktur, die sie erhält, und füllt diese Knoten gut. Das bedeutet Tiefe in Bereichen, die ohnehin schon erfolgreich waren, und nichts in den Bereichen, die abgedeckt werden mussten. Ein substitutionsbasierter CDT verteilt die Knoten genauer entlang der tatsächlichen Nachfrage der Shopper, sodass die Optimierung die richtigen Dinge schützt.
Der zweite Vorteil: Co-Occurrence-Daten im Transaktionsmaßstab lassen sich schwerer anfechten als der CDT eines Anbieters. Eine vom Lieferanten erstellte Hierarchie kann man aus dem Bauch heraus infrage stellen, konsistente Co-Occurrence-Muster über Hunderttausende Warenkörbe hinweg sind dagegen schwerer von der Hand zu weisen. Wenn die Daten etwas Unerwartetes zeigen, deutet das meist auf etwas hin, das der letzte Category-Workshop übersehen hat. Genau darum geht es.
Der dritte Vorteil ist die Skalierbarkeit. Ein manuell erstellter CDT ist die Arbeit einer einzelnen Person, einmal pro Kategorie und Zyklus, und dadurch begrenzt, wie viele Kategorien diese Person pro Jahr bearbeiten kann. Ein Modell, das Co-Occurrence-Muster aus Transaktionsdaten erkennt, kann viele Kategorien gleichzeitig abdecken. Die Fachleute prüfen und validieren dann die Ergebnisse, statt bei null anzufangen. Die Arbeit verlagert sich vom Aufbauen zum Hinterfragen, und das ist ein besserer Einsatz von Category-Expertise.
Was nötig ist, um einen Consumer Decision Tree aus Daten zum Shopper-Verhalten aufzubauen
Einen verhaltensbasierten CDT aufzubauen, ist mehr als eine Frage der Methodik. Es gibt auch konkrete Anforderungen an Daten und Technologie.
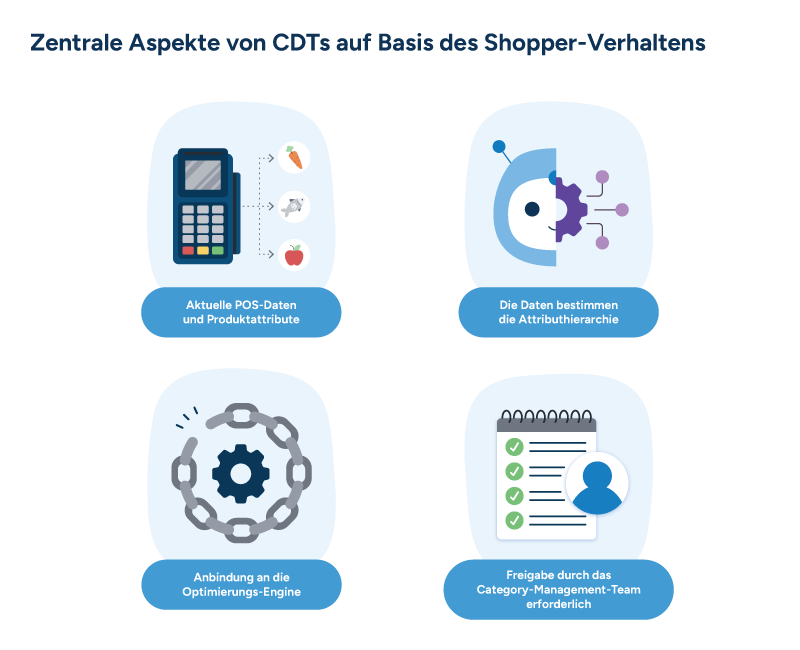
Aktuelle POS-Daten auf Warenkorbebene und Produktattribute
Die Grundlage besteht aus zwei Dingen, die zusammenwirken:
- Transaktionsdaten, die erfassen, was Shopper im Zeitverlauf in Warenkörben und bei Einkäufen gekauft haben
- Ein sauberer Export der Produktattribute, der die Eigenschaften jeder SKU beschreibt (Format, Marke, Geschmacksrichtung, Preislage usw.)
Das Substitutionssignal stammt aus individuellen Kaufmustern und nicht aus Kategoriesummen, daher genügen aggregierte Verkaufsdaten nicht. Das Modell braucht beide Datenquellen, um zu erkennen, welche Attribute die Unterschiede zwischen Produkten erklären, die Shopper als Substitute behandeln.
Ein trainiertes Modell, das Attribute nach ihrer Erklärungskraft einstuft
Der entscheidende Unterschied zwischen einem verhaltensbasierten und einem herkömmlichen CDT liegt darin, wie die Hierarchie bestimmt wird.
In einem klassischen CDT legt jemand vorab fest, dass die Marke über dem Format steht oder das Format über der Größe, auf Basis von Einschätzung oder Konvention.
Bei einem Ansatz auf Basis von Co-Occurrence-Mustern liest ein trainiertes Modell die Transaktionsdaten des Händlers und entscheidet, nach welchen Attributen es verzweigt und in welcher Reihenfolge. Grundlage ist, wie gut jedes Attribut die Unterschiede zwischen Produkten an der jeweiligen Verzweigung erklärt.
Das Ergebnis ist eine Hierarchie, die aus dem tatsächlichen Shopper-Verhalten abgeleitet wurde. Produkte im selben Endknoten gelten nach dieser Logik als Substitute: das, wonach Shopper greifen, wenn ihre erste Wahl nicht verfügbar ist.
Eine direkte Anbindung an die Optimierungs-Engine
Ein CDT, der isoliert vom Prozess der Sortimentsplanung existiert, löst nur einen Teil des Problems. Auch die nachgelagerten Fragen müssen dieselbe Shopper-Logik übernehmen, aus der der CDT aufgebaut wurde: „Welche Produkte sind Kernartikel?“, „Welche sind optional?“ und „Was wird bereinigt?“
Fließt der CDT direkt in die Sortimentsoptimierungs-Engine eines Planungssystems ein, wirkt seine Struktur auf jede Sortimentsentscheidung. Die Engine kann dann jeden Endknoten als Abdeckungsvorgabe nutzen. So enthält das Sortiment mindestens ein Produkt je Konsumentenbedürfnis, statt anhand aggregierter Kategoriesummen aufgefüllt zu werden.
Ein Aktivierungsmodell, das die Kontrolle bei den Fachleuten lässt
Ein Modell, das CDTs automatisch erzeugt und ohne Prüfung bereitstellt, schafft ein anderes Problem. Category Manager verlieren den Überblick darüber, was sich geändert hat und warum, und das Vertrauen schwindet schnell.
Der richtige Ansatz ist, neue CDTs standardmäßig als inaktiv zu erzeugen. Das heißt: Nichts geht live, bis ein Category Manager die Ergebnisse geprüft, die Knoten bezeichnet, die Substitutionsgruppen an der kommerziellen Realität validiert und das Update ausdrücklich freigegeben hat. Dieser Teil der Methode wird am leichtesten unterschätzt, ist aber auch der Teil, der den Rest erst funktionieren lässt.
Category Manager, die so arbeiten, wissen genau, wie sich das anfühlen muss. Ziel ist, sich hinzusetzen, den Kopf frei zu haben und das Gefühl zu bekommen, selbst am eigenen CDT zu arbeiten, statt festzustellen, dass er ihnen bereits abgenommen wurde. Das Modell läuft nach Zeitplan, und die Category Manager entscheiden, wann die neue Version live geht.
Die Rolle des Urteilsvermögens verschiebt sich: weg vom Aufbau eines CDT auf dem leeren Blatt, hin zum Hinterfragen dessen, was die Daten gefunden haben, und zur Entscheidung, welchen Teilen man vertrauen kann. Das ist ein produktiverer Einsatz von Category-Expertise als die manuelle Attributklassifizierung.
So setzt RELEX CDT Builder diese Methode in der Praxis um
RELEX CDT Builder vereint die Datenbasis, den Modellierungsansatz und das Aktivierungsmodell, die für den Aufbau verhaltensbasierter CDTs nötig sind. Er ist Teil von RELEX Assortment Planning auf der einheitlichen RELEX-Plattform und verbindet Sortimentsentscheidungen mit der Flächen-, Nachfrage- und Dispositionsplanung.
Der Prozess nutzt ein trainiertes Topic-Modell, um Verhaltensmuster aus Warenkorbdaten zu lernen. Ein typischer Lauf zum Erstellen eines CDT dauert pro Kategorie wenige Minuten und lässt sich auf Kategorieebene konfigurieren. Category Manager steuern die maximale Baumtiefe und die minimale Knotengröße und legen fest, welche Attribute auf jedem Pfad vorkommen müssen oder nicht vorkommen dürfen.
Der erzeugte CDT ist direkt mit dem Assortment Optimizer verbunden, in dem jeder Endknoten als Abdeckungsvorgabe fungiert. Der Optimizer stellt sicher, dass das Sortiment mindestens ein Produkt je Konsumentenbedürfnis enthält. Tiefe in erfolgreichen Knoten und Abdeckung unterversorgter Knoten werden so gemeinsam gesteuert, statt miteinander zu konkurrieren. Category Manager prüfen und bezeichnen die Ergebnisse, validieren die Substitutionsgruppen anhand ihres Kategoriewissens und aktivieren den CDT, wenn sie zufrieden sind. So behalten sie die volle Kontrolle darüber, was wann live geht.
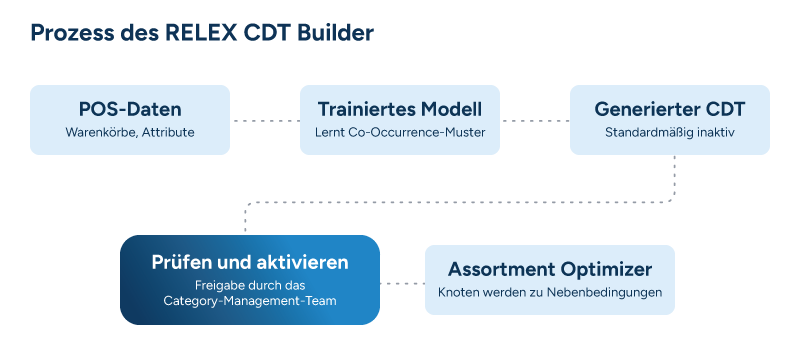
Für Teams, die große oder komplexe Kategorieportfolios steuern, ist der Zugewinn an Skalierbarkeit enorm. CDT Builder arbeitet viele Kategorien gleichzeitig ab, während Category Manager die Ergebnisse prüfen und validieren, statt bei null anzufangen. Die Arbeit verlagert sich vom Aufbauen zum Hinterfragen, und Kategorien, die früher monatelang auf einen manuellen Neuaufbau warten mussten, werden stattdessen nach einem modellgesteuerten Zeitplan aktualisiert.
Die langfristige Ausrichtung baut auf dieser Grundlage auf. Prognosen, die Nachfrageverlagerung berücksichtigen, darunter die Prognose neuer Artikel über die Zuordnung zu CDT-Knoten, übertragen dieselbe verhaltensbasierte Logik künftig von Sortimentsentscheidungen auf den gesamten Planungsprozess.
Sorgen Sie dafür, dass sich der nächste CDT-Neuaufbau lohnt
Die meisten Category Manager arbeiten mit einem CDT, den jemand anderes mit einer damals sinnvollen Methode erstellt hat und der inzwischen dringend aktualisiert werden muss. Die Frage ist, ob die nächste Version auf dem tatsächlichen Verhalten der Shopper beruht oder auf denselben Annahmen wie die letzte.
Wer diesen Wandel angehen möchte, findet in RELEX Assortment Planning den praktischen nächsten Schritt. Die Lösung baut auf der substitutionsbasierten Methode auf und ist darauf ausgelegt, Category Managern die Kontrolle über die Struktur zurückzugeben, von der ihre Sortimente abhängen.
Beitrag von

ähnliche Artikel
Agentische KI für die Supply-Chain-Planung in der Produktion
Erfahren Sie, wie agentische KI Herstellern bei Prognoseprüfung, Engpässen und Stresstests hilft: mit Standard- und maßgeschneiderten Agenten auf RELEX Open.
7 Wege, wie KI-gestützte Planungssoftware die Supply-Chain-Herausforderungen der Fleischverarbeitung löst
Entdecken Sie sieben KI-Planungsfunktionen, die Margenlücken in der Fleischverarbeitung schließen und Angebot, Nachfrage und Haltbarkeit ausbalancieren.
Kundenstory: Premium Nexus
Premium Nexus ist ein großer Franchisenehmer der CU-Marke von BGF Retail und betreibt heute über 600 Filialen sowie drei Vertriebszentren in der gesamten Mongolei.