Comment construire un arbre de décision du consommateur : les meilleurs arbres partent du comportement d’achat, pas de la logique d’offre
Nov 5, 2026 • 13 min
Construire un arbre de décision du consommateur (Consumer Decision Tree, CDT) paraît assez simple, tant que personne ne se demande : « Qui l’a construit ? » et « Comment a-t-il été construit ? »
La plupart des category managers n’ont pas construit leur CDT. Ils l’ont hérité d’un fournisseur de marque, d’un cabinet de conseil ou d’une équipe catégorie interne depuis longtemps passée à autre chose. Pourtant, ils n’ont cessé d’optimiser à l’intérieur de ce cadre. Chaque année, ils mettent à jour les produits et débattent de l’intitulé des nœuds. Ils mènent leurs revues d’assortiment à partir d’une structure construite une seule fois par quelqu’un d’autre, pour des raisons qui ne sont peut-être plus d’actualité.
Le sujet est plus important qu’il n’en a l’air. Un arbre de décision du consommateur est le socle de chaque décision d’assortiment d’un retailer. Il détermine quels produits sont retenus ou écartés selon les différents besoins consommateurs, pour obtenir la largeur et la profondeur justes d’un assortiment optimal.
Avec une structure erronée, un retailer peut afficher de bons résultats sur tous les indicateurs financiers tout en laissant en silence un besoin consommateur entier non couvert. Aucun signal d’alerte ne ressort des données, car l’arbre ne reflète pas la façon dont les clients décident réellement.
Mettre à jour l’arbre existant ne suffit pas. La solution : construire le prochain à partir du comportement d’achat réel. Celui-ci se lit dans la façon dont les produits se retrouvent dans les mêmes paniers et les mêmes visites, au fil du temps.
Comment les CDT sont construits aujourd’hui
Plusieurs approches courantes mènent les category managers à un arbre de décision du consommateur. Chacune a sa propre méthode, mais toutes partagent la même limite de fond : ces arbres figent un instantané unique, qui reste inchangé pendant que la catégorie évolue.
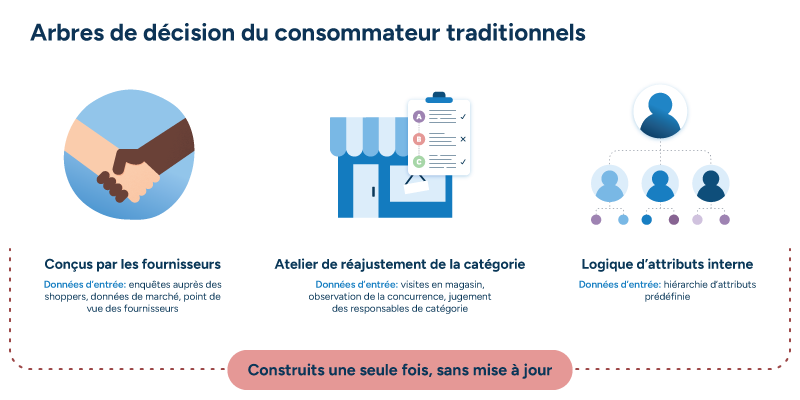
Arbres conçus par les fournisseurs
Cette source est la plus répandue pour les CDT. Les fournisseurs de marque et les cabinets de conseil spécialisés en gestion des catégories apportent une vraie connaissance des catégories. Ils disposent aussi de capacités d’étude que la plupart des retailers n’ont pas en interne, ce qui en fait des partenaires naturels pour ce type de travail. Ces travaux associent en général enquêtes auprès des clients, données de marché et expertise de la catégorie. Ils débouchent sur une hiérarchie d’attributs classés dans l’ordre dans lequel le fournisseur estime que les clients décident de leurs achats.
L’arbre obtenu indique quels produits vont ensemble et comment parcourir la catégorie. Il part du nœud de catégorie de premier niveau et descend jusqu’aux UGS individuelles, au niveau des feuilles (les nœuds les plus bas).
Ateliers de refonte de catégorie
Les retailers qui construisent eux-mêmes leur CDT disposent d’une alternative : l’atelier de refonte de catégorie. Visites de magasins, observation de la concurrence et jugement des category managers sont réunis dans un exercice structuré. Celui-ci s’appuie sur une connaissance de terrain de la catégorie, à un moment donné. Le résultat est une hiérarchie bâtie sur l’observation directe de la façon dont les catégories sont organisées sur le marché. Elle est interprétée à la lumière de l’expertise de l’équipe catégorie et croisée avec les données de performance des ventes pour valider la structure.
Logique d’attributs interne
La troisième approche est souvent la moins interrogée. Les arbres de décision sont construits à partir de hiérarchies d’attributs produit, définies en interne par l’équipe catégorie selon l’organisation de la catégorie. Les attributs sont classés dans un ordre qui reflète la compréhension qu’a l’équipe de la catégorie. Les produits sont ensuite affectés aux nœuds selon la place que leurs attributs leur donnent dans cette hiérarchie.
Les attributs classés peuvent être les suivants :
- Marque
- Taille
- Format
- Goût
- Niveau de prix
Chaque nœud terminal regroupe alors les produits qui partagent le même chemin d’attributs, du haut en bas de l’arbre.
Pourquoi les CDT hérités laissent-ils des besoins consommateurs non couverts ?
Chaque méthode courante de construction a sa propre faiblesse, mais toutes aboutissent à la même conséquence, peu importe la façon dont l’arbre a été conçu. Le CDT détermine ce qui est protégé. Si un besoin consommateur n’est pas représenté dans l’arbre, le système n’a aucun moyen de signaler son absence. Il remplit simplement l’assortiment à partir des nœuds qui existent, et le manque reste invisible.
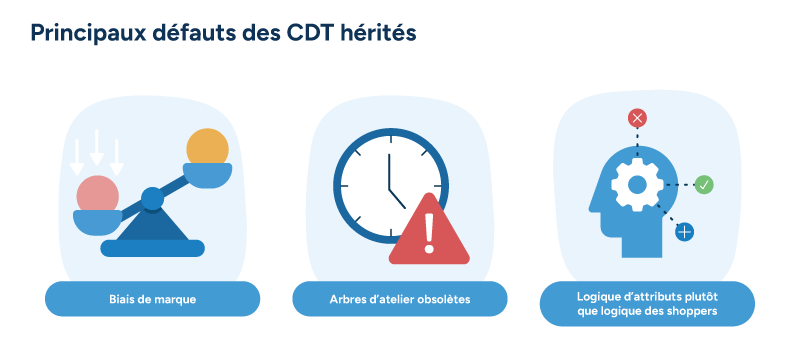
Le biais fournisseur place la marque tout en haut
Quand la marque occupe le haut de la hiérarchie parce qu’un fournisseur l’y a placée, l’arbre reflète les priorités du fournisseur, pas les décisions des clients. Un client dont le premier critère est l’occasion, le format ou le pays d’origine parcourt la catégorie dans un ordre que l’arbre ne modélise pas. L’assortiment peut sembler complet selon la logique de l’arbre, tout en répondant systématiquement mal aux clients pour qui la marque n’est pas le premier critère. Aucun mécanisme ne fait remonter ce problème, car l’arbre définit lui-même ce que signifie « complet ».
Les arbres d’atelier vieillissent mal
Un atelier de refonte de catégorie produit un instantané. Il est utile à court terme. Mais le comportement des clients évolue, de nouveaux formats apparaissent, la dynamique concurrentielle change et les marques de distributeur (MDD) progressent, alors que l’arbre ne suit pas. Le category manager sent peut-être que quelque chose cloche, mais le CDT ne le confirme pas : il a été construit pour refléter un moment désormais dépassé. Le mettre à jour suppose de refaire l’atelier, donc d’attendre le prochain cycle pour faire les ajustements nécessaires.
La logique d’attributs confond organisation et insight
Un arbre construit à partir des attributs produit (marque, taille, goût ou format, par exemple) reflète l’organisation de la catégorie dans une base de données. Il ne reflète pas forcément la façon dont un client avance dans sa décision. Les deux peuvent se ressembler sur le papier, mais diverger nettement dans la pratique. Si un client change de marque plutôt que de format, alors que l’arbre place la marque au-dessus du format, la hiérarchie est inversée par rapport au comportement réel. Les décisions d’assortiment qui en découlent sont optimisées en fonction de la mauvaise logique.
Une meilleure méthode pour construire un arbre de décision du consommateur : partir des données de substitution
La méthode qui règle tous les problèmes des CDT hérités commence par une autre question. Au lieu de demander : « Comment classer ces produits ? », demandez-vous : « Quels produits les clients jugent-ils réellement substituables entre eux ? »
Le point de départ : les données de transaction en caisse (POS, Point of Sale). Elles retracent les achats réels des clients, panier par panier et visite par visite, au fil du temps. Plutôt que d’imposer une hiérarchie fondée sur les attributs produit ou sur l’apport des fournisseurs, les category managers laissent les schémas de cooccurrence présents dans les données définir la structure.
L’arbre qui en ressort reflète le comportement des clients quand leur premier choix n’est pas disponible, ou quand ils comparent les options au sein d’une catégorie. Ce CDT ne repose ni sur le comportement qu’un fournisseur attend des clients, ni sur l’état de la catégorie lors d’un atelier de refonte vieux de deux ans.
Plutôt que d’imposer une hiérarchie fondée sur les attributs produit ou sur l’apport des fournisseurs, les category managers laissent les schémas de cooccurrence présents dans les données définir la structure.
En pratique, la hiérarchie obtenue est souvent surprenante. Pour une catégorie hygiène-beauté, un arbre conçu par un fournisseur peut placer la marque en haut de la hiérarchie, alors que les données de transaction racontent une autre histoire. Le mode d’application peut compter davantage que la marque pour les clients dont le premier choix est en rupture de stock.
Par exemple, un client peut préférer une autre marque de déodorant plutôt que de passer du roll-on au spray. Si ce schéma se vérifie de façon constante sur des milliers de transactions, l’arbre doit en rendre compte. Il ne doit pas se construire à partir des seuls attributs produit ou de l’apport des fournisseurs.
Le principe de fond est simple. Le CDT doit refléter le comportement des consommateurs à l’état pur. La connaissance de la catégorie sert ensuite à expliquer et à nommer ce que les données font ressortir. Les données définissent la structure. Le category manager l’interprète, nomme les nœuds et la rend exploitable.
Pourquoi les CDT fondés sur la substitution produisent des assortiments plus performants
Le premier avantage des CDT fondés sur la substitution est la couverture. Sans arbre fidèle, les produits les plus vendus d’une catégorie ont tendance à se concentrer dans un ou deux nœuds. L’optimiseur d’assortiment travaille correctement à partir de la structure qui lui est fournie et remplit bien ces nœuds. Résultat : de la profondeur là où la catégorie gagnait déjà, et rien là où la couverture faisait défaut. Un arbre fondé sur la substitution répartit les nœuds plus justement sur la structure réelle de la demande des clients, et l’optimiseur protège ainsi les bons éléments.
Deuxième avantage : les données de cooccurrence à l’échelle des transactions sont difficiles à contester, contrairement au CDT d’un fournisseur. Une hiérarchie conçue par un fournisseur peut être remise en cause au nom de l’intuition. Des schémas de cooccurrence constants sur des centaines de milliers de paniers sont bien plus difficiles à écarter. Quand les données révèlent une surprise, elles pointent le plus souvent ce que le dernier atelier de catégorie n’avait pas vu : tout l’intérêt est là.
Troisième avantage : l’évolutivité. Un CDT construit à la main est l’effort d’une seule personne, fourni une fois par catégorie et par cycle. Cet effort est limité au nombre de catégories qu’elle peut traiter en un an. Un modèle qui repère les schémas de cooccurrence dans les données de transaction peut tourner sur de nombreuses catégories à la fois. Le category manager relit et valide les résultats, au lieu de partir de zéro. Le travail passe de la construction à l’examen critique, ce qui valorise mieux l’expertise catégorie.
Les prérequis pour construire un arbre de décision du consommateur à partir des données de comportement d’achat
Construire un CDT fondé sur le comportement ne se résume pas à un choix de méthode. Cela suppose aussi des exigences concrètes en matière de données et de technologie.
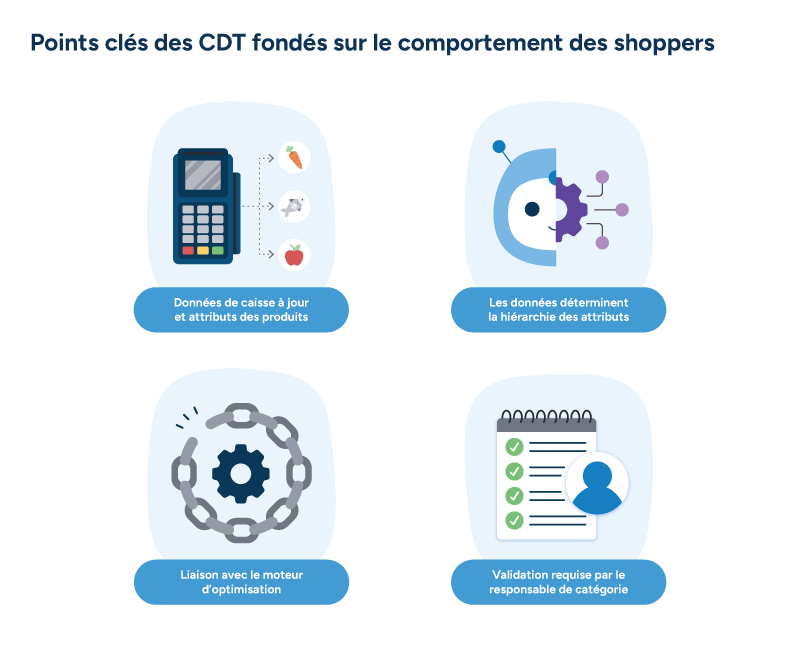
Des données de caisse à jour, par panier, et des attributs produit
Le socle repose sur deux éléments qui fonctionnent ensemble :
- Des données de transaction qui retracent ce que les clients ont acheté, panier par panier et visite par visite, au fil du temps
- Un export propre des attributs produit, qui décrit les propriétés de chaque UGS (format, marque, goût, niveau de prix, etc.)
Le signal de substitution provient des comportements d’achat individuels, pas des totaux de catégorie : les données de ventes agrégées ne suffisent donc pas. Le modèle a besoin de ces deux sources pour identifier les attributs qui expliquent les différences entre les produits que les clients jugent substituables.
Un modèle entraîné qui classe les attributs selon leur pouvoir explicatif
La principale différence entre un arbre fondé sur le comportement et un arbre conventionnel tient à la façon dont la hiérarchie est déterminée.
Dans un CDT traditionnel, quelqu’un décide à l’avance que la marque se place au-dessus du format, ou le format au-dessus de la taille, selon son jugement ou par convention.
Dans une approche fondée sur les schémas de cooccurrence, un modèle entraîné lit les données de transaction du retailer. Il décide des attributs à utiliser pour chaque scission, et dans quel ordre. Ce choix repose sur la capacité de chaque attribut à expliquer les différences entre les produits à chaque branche.
Le résultat est une hiérarchie issue du comportement d’achat réel. Selon cette logique, les produits d’un même nœud terminal sont substituables. Un client se tourne vers eux quand son premier choix n’est pas disponible.
Une connexion directe au moteur d’optimisation
Un CDT isolé du processus de planification de l’assortiment ne résout qu’une partie du problème. Les décisions en aval, comme « quels produits font partie du socle ? », « lesquels sont optionnels ? » ou « quels produits rationaliser ? », doivent reprendre la logique client dont l’arbre est issu.
Quand le CDT alimente directement le moteur d’optimisation de l’assortiment d’un système de planification, sa structure se répercute sur chaque décision d’assortiment. L’optimiseur peut alors traiter chaque nœud terminal comme une contrainte de couverture. L’assortiment contient ainsi au moins un produit pour chaque besoin consommateur, au lieu d’être rempli à partir des totaux agrégés de la catégorie.
Un modèle d’activation qui laisse la main aux category managers
Un modèle qui génère des arbres de décision automatiquement et les déploie sans relecture crée un autre problème. Les category managers perdent la visibilité sur ce qui a changé et pourquoi, et la confiance s’érode vite.
La bonne approche consiste à générer les nouveaux arbres en mode inactif par défaut. Rien n’est donc mis en production tant qu’un category manager n’a pas relu les résultats et nommé les nœuds. Il doit aussi valider les groupes de substitution face à la réalité commerciale, puis approuver explicitement la mise à jour. Cet aspect de la méthode est le plus facile à sous-estimer, mais aussi celui qui fait tenir tout le reste.
Les category managers qui travaillent ainsi savent précisément ce qu’ils attendent de l’expérience. Ils veulent pouvoir s’y consacrer pleinement, l’esprit disponible, et avoir le sentiment de faire eux-mêmes leur CDT, sans découvrir qu’il a déjà été fait à leur place. Le modèle tourne selon un calendrier défini. Le category manager décide quand la nouvelle version est mise en production.
Le jugement ne sert plus à construire un arbre à partir d’une page blanche. Il sert à examiner de façon critique ce que les données ont révélé et à décider de ce qui mérite confiance. Cet usage de l’expertise catégorie est bien plus productif que le classement manuel des attributs.
Comment RELEX CDT Builder met cette méthode en pratique
RELEX CDT Builder réunit les données d’entrée, l’approche de modélisation et le modèle d’activation qu’exige la construction d’un CDT fondé sur le comportement. Il fait partie de RELEX Assortment Planning, au sein de la plateforme unifiée de RELEX. Les décisions d’assortiment se relient ainsi à la planification de l’espace, de la demande et du réapprovisionnement.
Le processus s’appuie sur un modèle thématique entraîné pour apprendre les schémas de comportement à partir des données de panier. Une exécution de construction type prend quelques minutes par catégorie et se configure au niveau de chaque catégorie. Les category managers peuvent paramétrer la profondeur maximale de l’arbre, la taille minimale des nœuds et les attributs qui doivent, ou ne doivent pas, figurer sur chaque chemin.
L’arbre généré se connecte directement à Assortment Optimizer, où chaque nœud terminal joue le rôle de contrainte de couverture. L’optimiseur garantit que l’assortiment contient au moins un produit par besoin consommateur. La profondeur dans les nœuds gagnants et la couverture des nœuds mal couverts se gèrent ainsi ensemble, et non l’une contre l’autre. Les responsables de catégorie relisent et nomment les résultats, confrontent les groupes de substitution à leur connaissance de la catégorie et activent l’arbre quand le résultat leur convient. Ils gardent ainsi la maîtrise totale de ce qui est mis en production, et du moment.
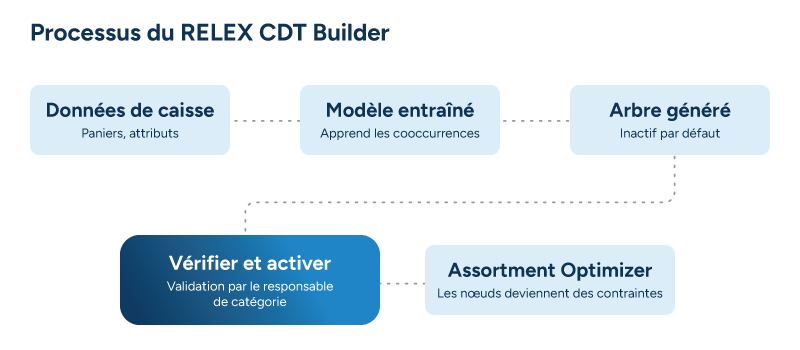
Pour les équipes qui gèrent des portefeuilles de catégories vastes ou complexes, le gain en évolutivité est considérable. CDT Builder tourne sur de nombreuses catégories à la fois, tandis que les responsables de catégorie relisent et valident les résultats au lieu de partir de zéro. Le travail passe de la construction à l’examen critique. Les catégories qui attendaient des mois une reconstruction manuelle sont désormais mises à jour selon un calendrier piloté par le modèle.
La vision à long terme prolonge ce socle. La prévision tenant compte du report de demande, y compris la prévision des nouveaux articles par affectation à un nœud du CDT, étendra la même logique comportementale. Elle ne se limitera plus aux décisions d’assortiment : elle gagnera l’ensemble du processus de planification.
Donnez tout son sens à la prochaine reconstruction du CDT
La plupart des category managers travaillent à partir d’un CDT construit par quelqu’un d’autre, selon une méthode qui avait du sens à l’époque. Or ce CDT a aujourd’hui un besoin criant de mise à jour. La question est de savoir si la prochaine version reposera sur la façon dont les clients se comportent vraiment, ou sur les mêmes hypothèses que la précédente.
Pour franchir le pas, RELEX Assortment Planning est l’étape suivante la plus concrète. Fondée sur la méthodologie de substitution, cette solution est conçue pour redonner aux category managers la maîtrise de la structure dont dépendent leurs assortiments.
Ecrit par
Articles associés
Au-delà de l’effet de mode : des agents IA RELEX conçus pour réussir dans le retail
Découvrez les 10 agents IA RELEX que les équipes supply chain exploitent pour améliorer leurs résultats : prévision, réapprovisionnement, prix et promotions.
L’IA agentique dans la planification de la supply chain des fabricants
Découvrez comment l’IA agentique aide les fabricants à revoir les prévisions, lever les contraintes et tester les plans avec des agents standard et sur mesure
7 façons dont la planification pilotée par l’IA résout les défis supply chain de la filière viande
Découvrez sept capacités de planification supply chain pilotées par l’IA pour refermer l’écart de marge dans la transformation de la viande rouge.